为什么需要独立的知识中心
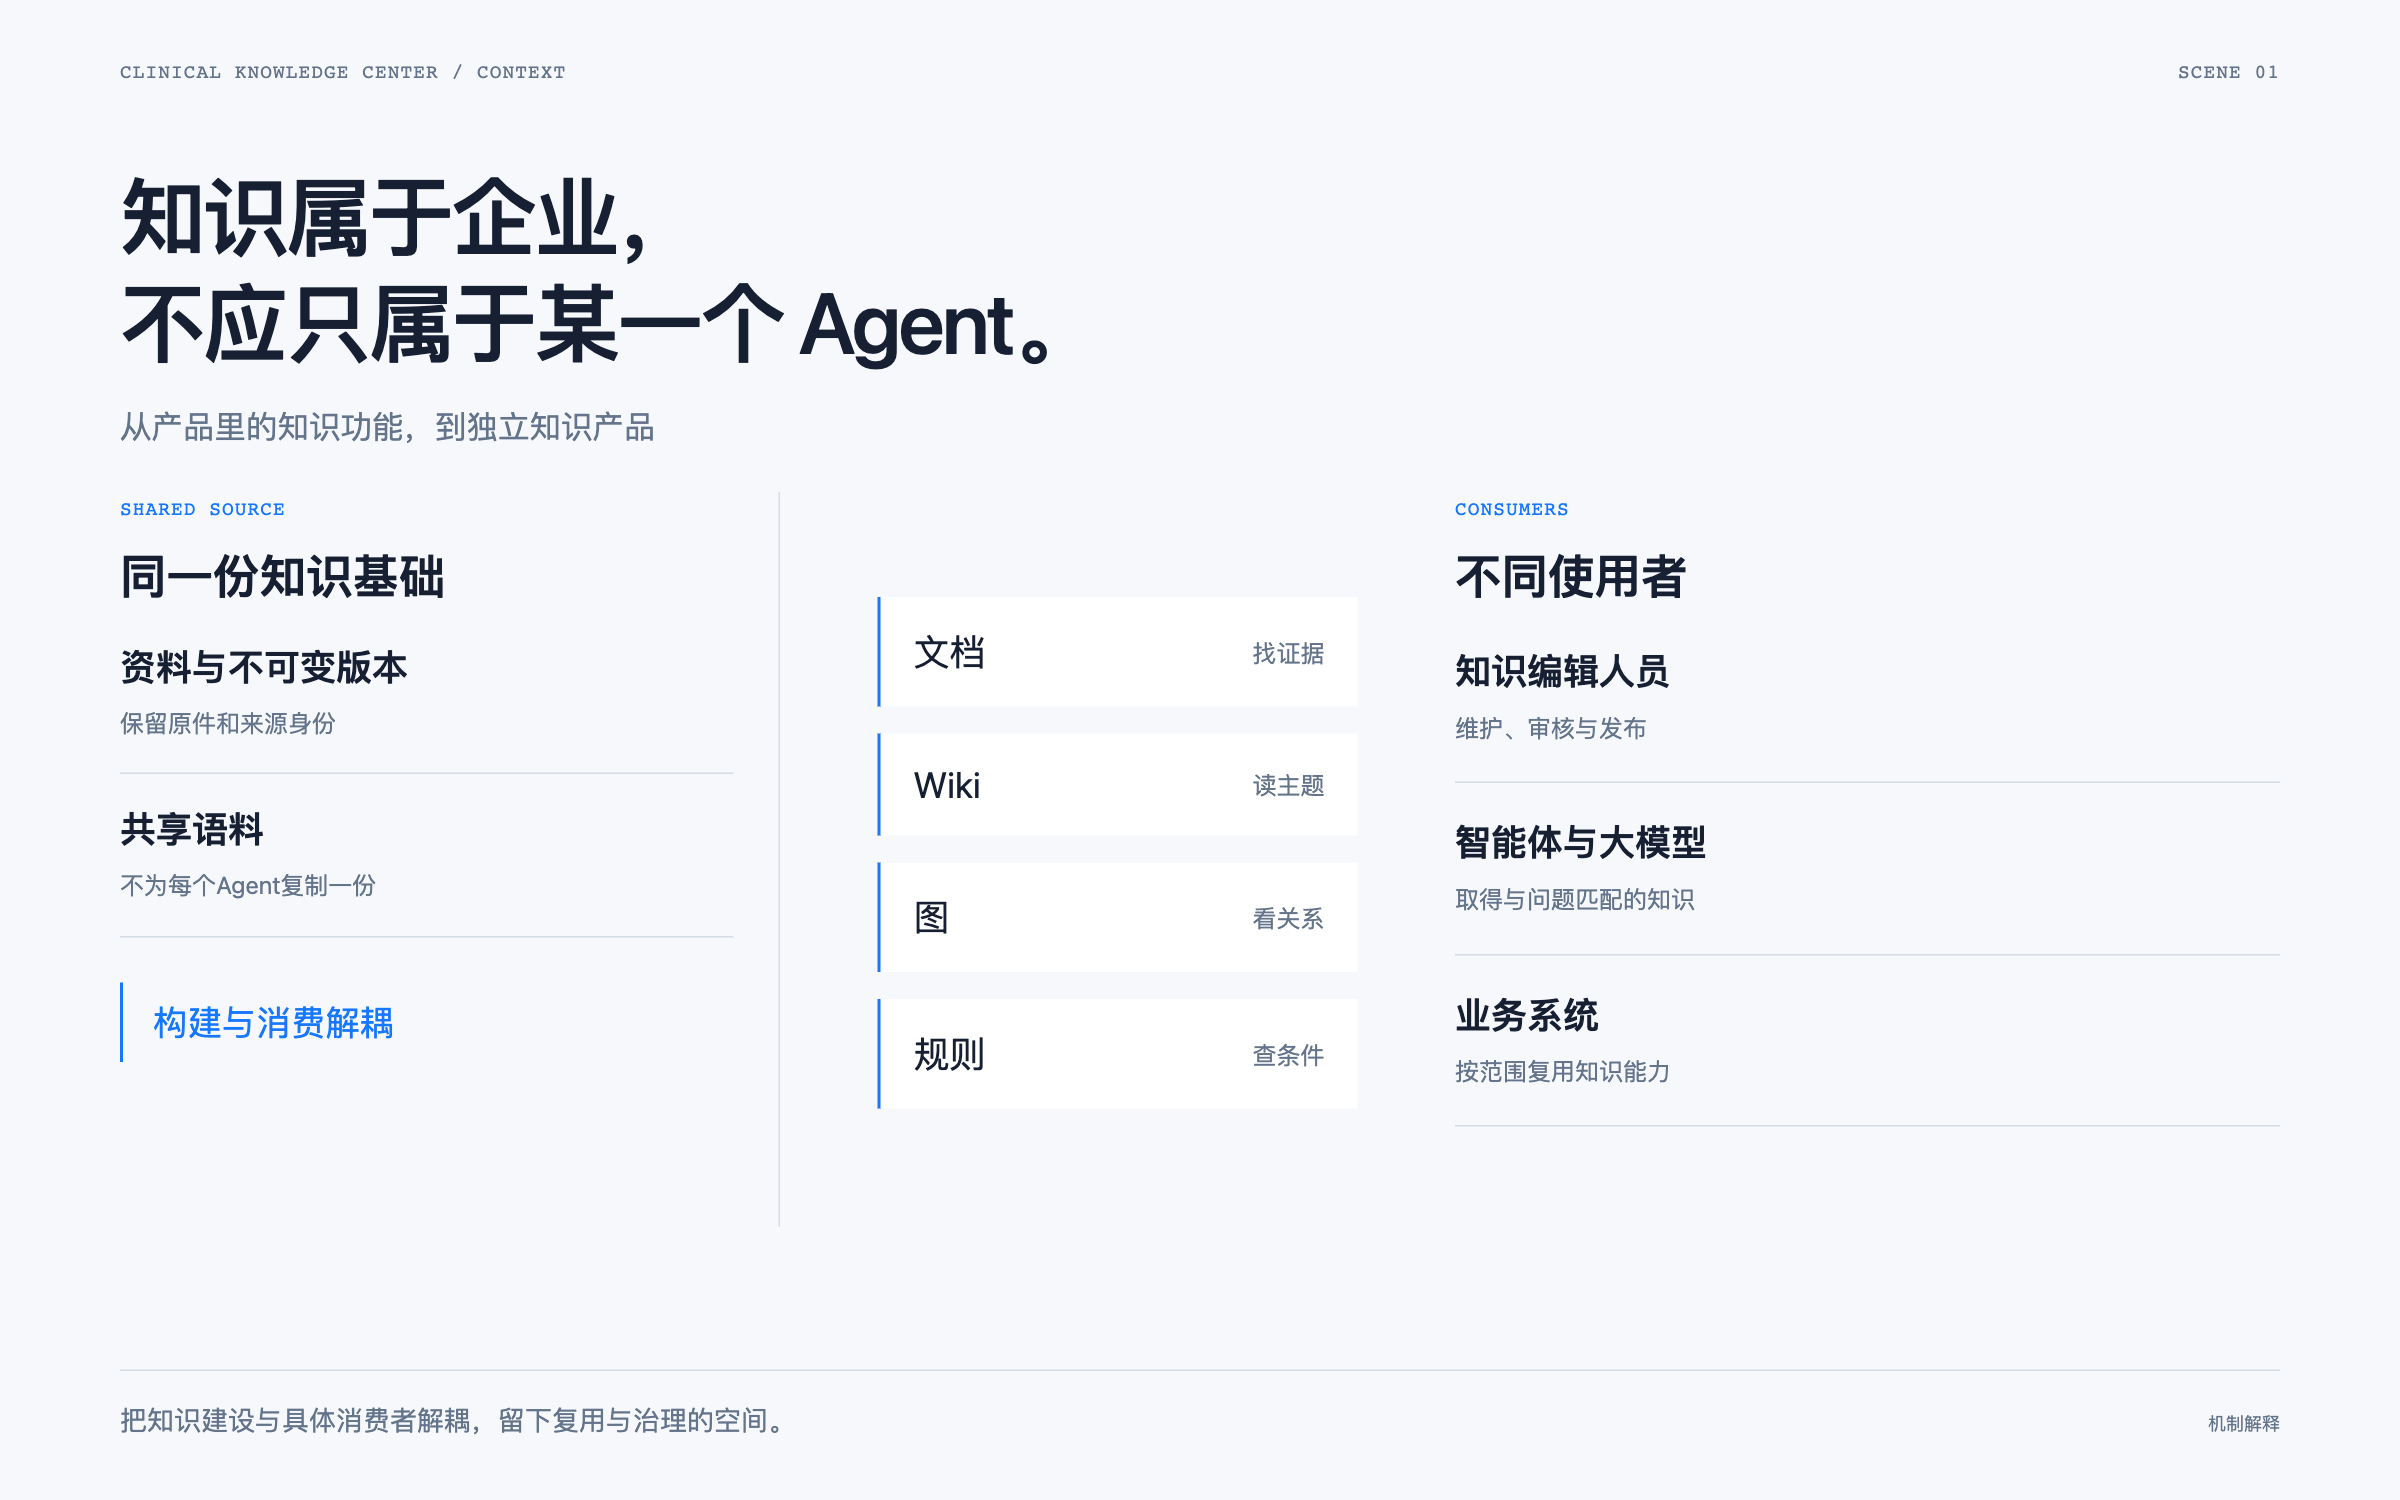
从产品里的知识功能,到独立知识产品
智能体需要知识,编辑人员需要维护,其他业务系统也可能需要同一份资料。我把知识中心的边界定义为独立资产:资料与语料先经过治理,消费者再按需要读取。构建与消费因此可以分开,同一来源可以进入不同产品形态。
资料、版本和出处
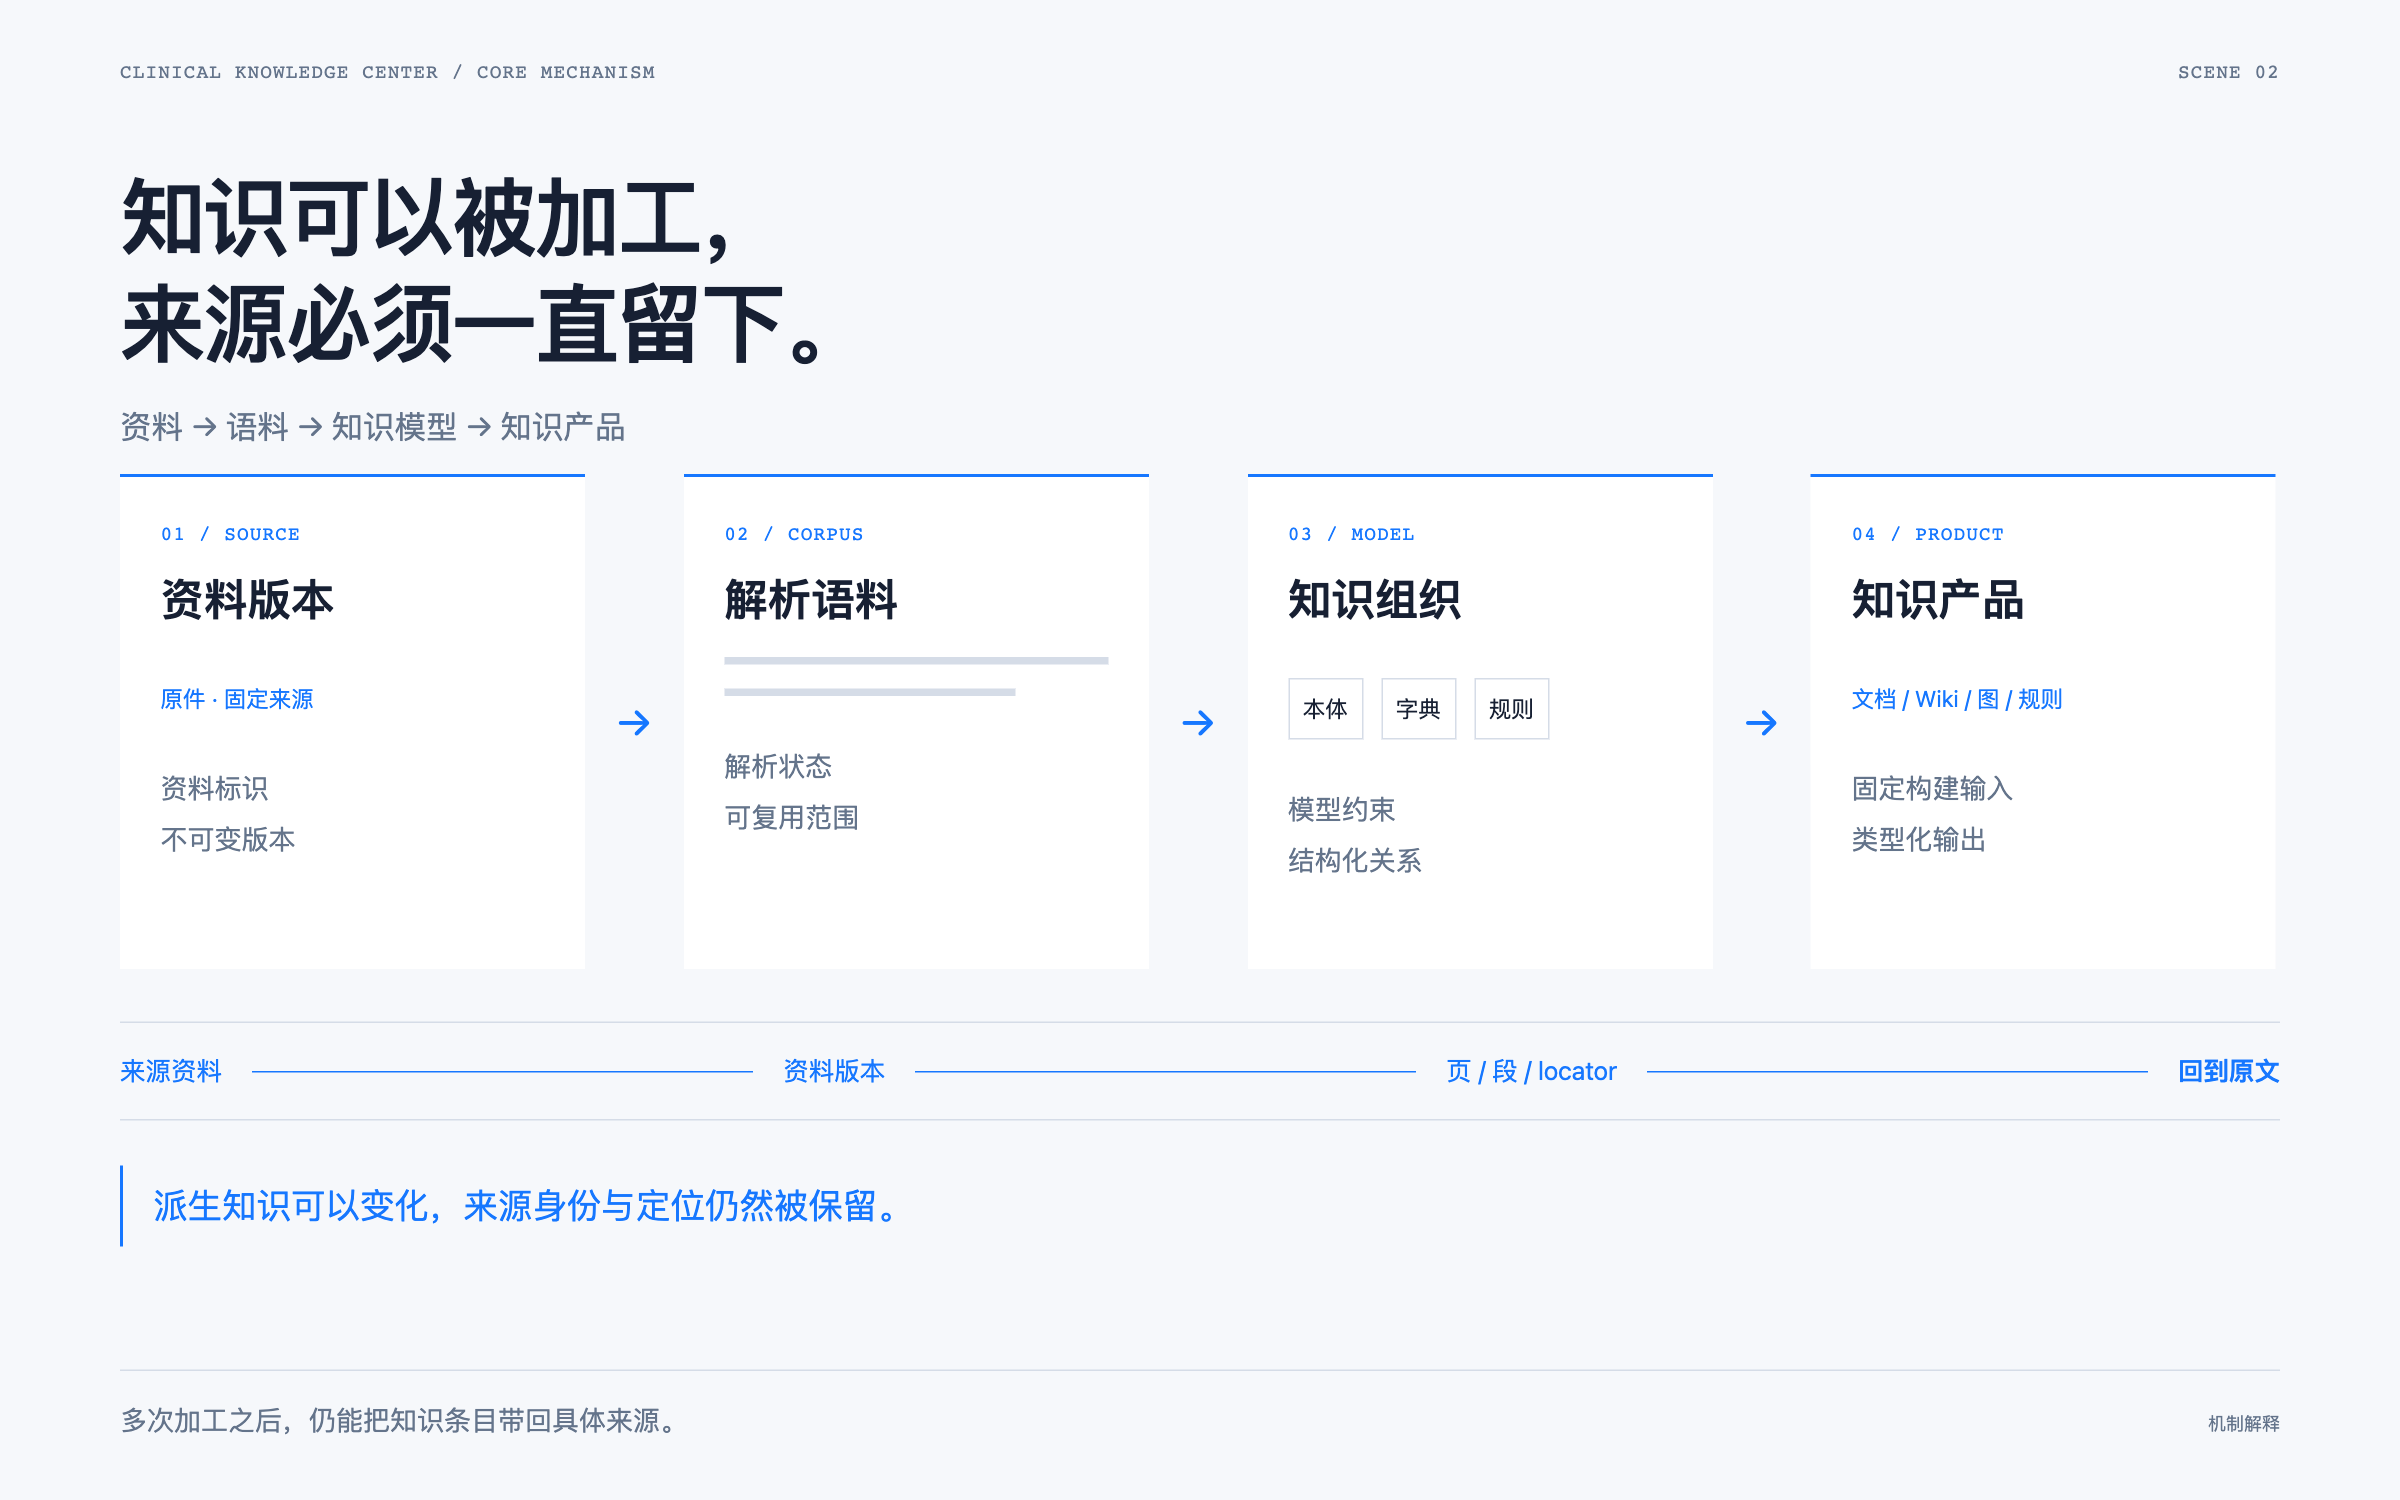
资料 → 语料 → 知识模型 → 知识产品
原始资料保留原件与版本,解析内容形成共享语料;知识产品引用固定输入,派生结果带着来源关系。我建设资料、语料与知识工作台,并围绕来源包、解析状态和证据定位持续治理,让“怎么来的”可以被回查。
文档、Wiki、图和规则
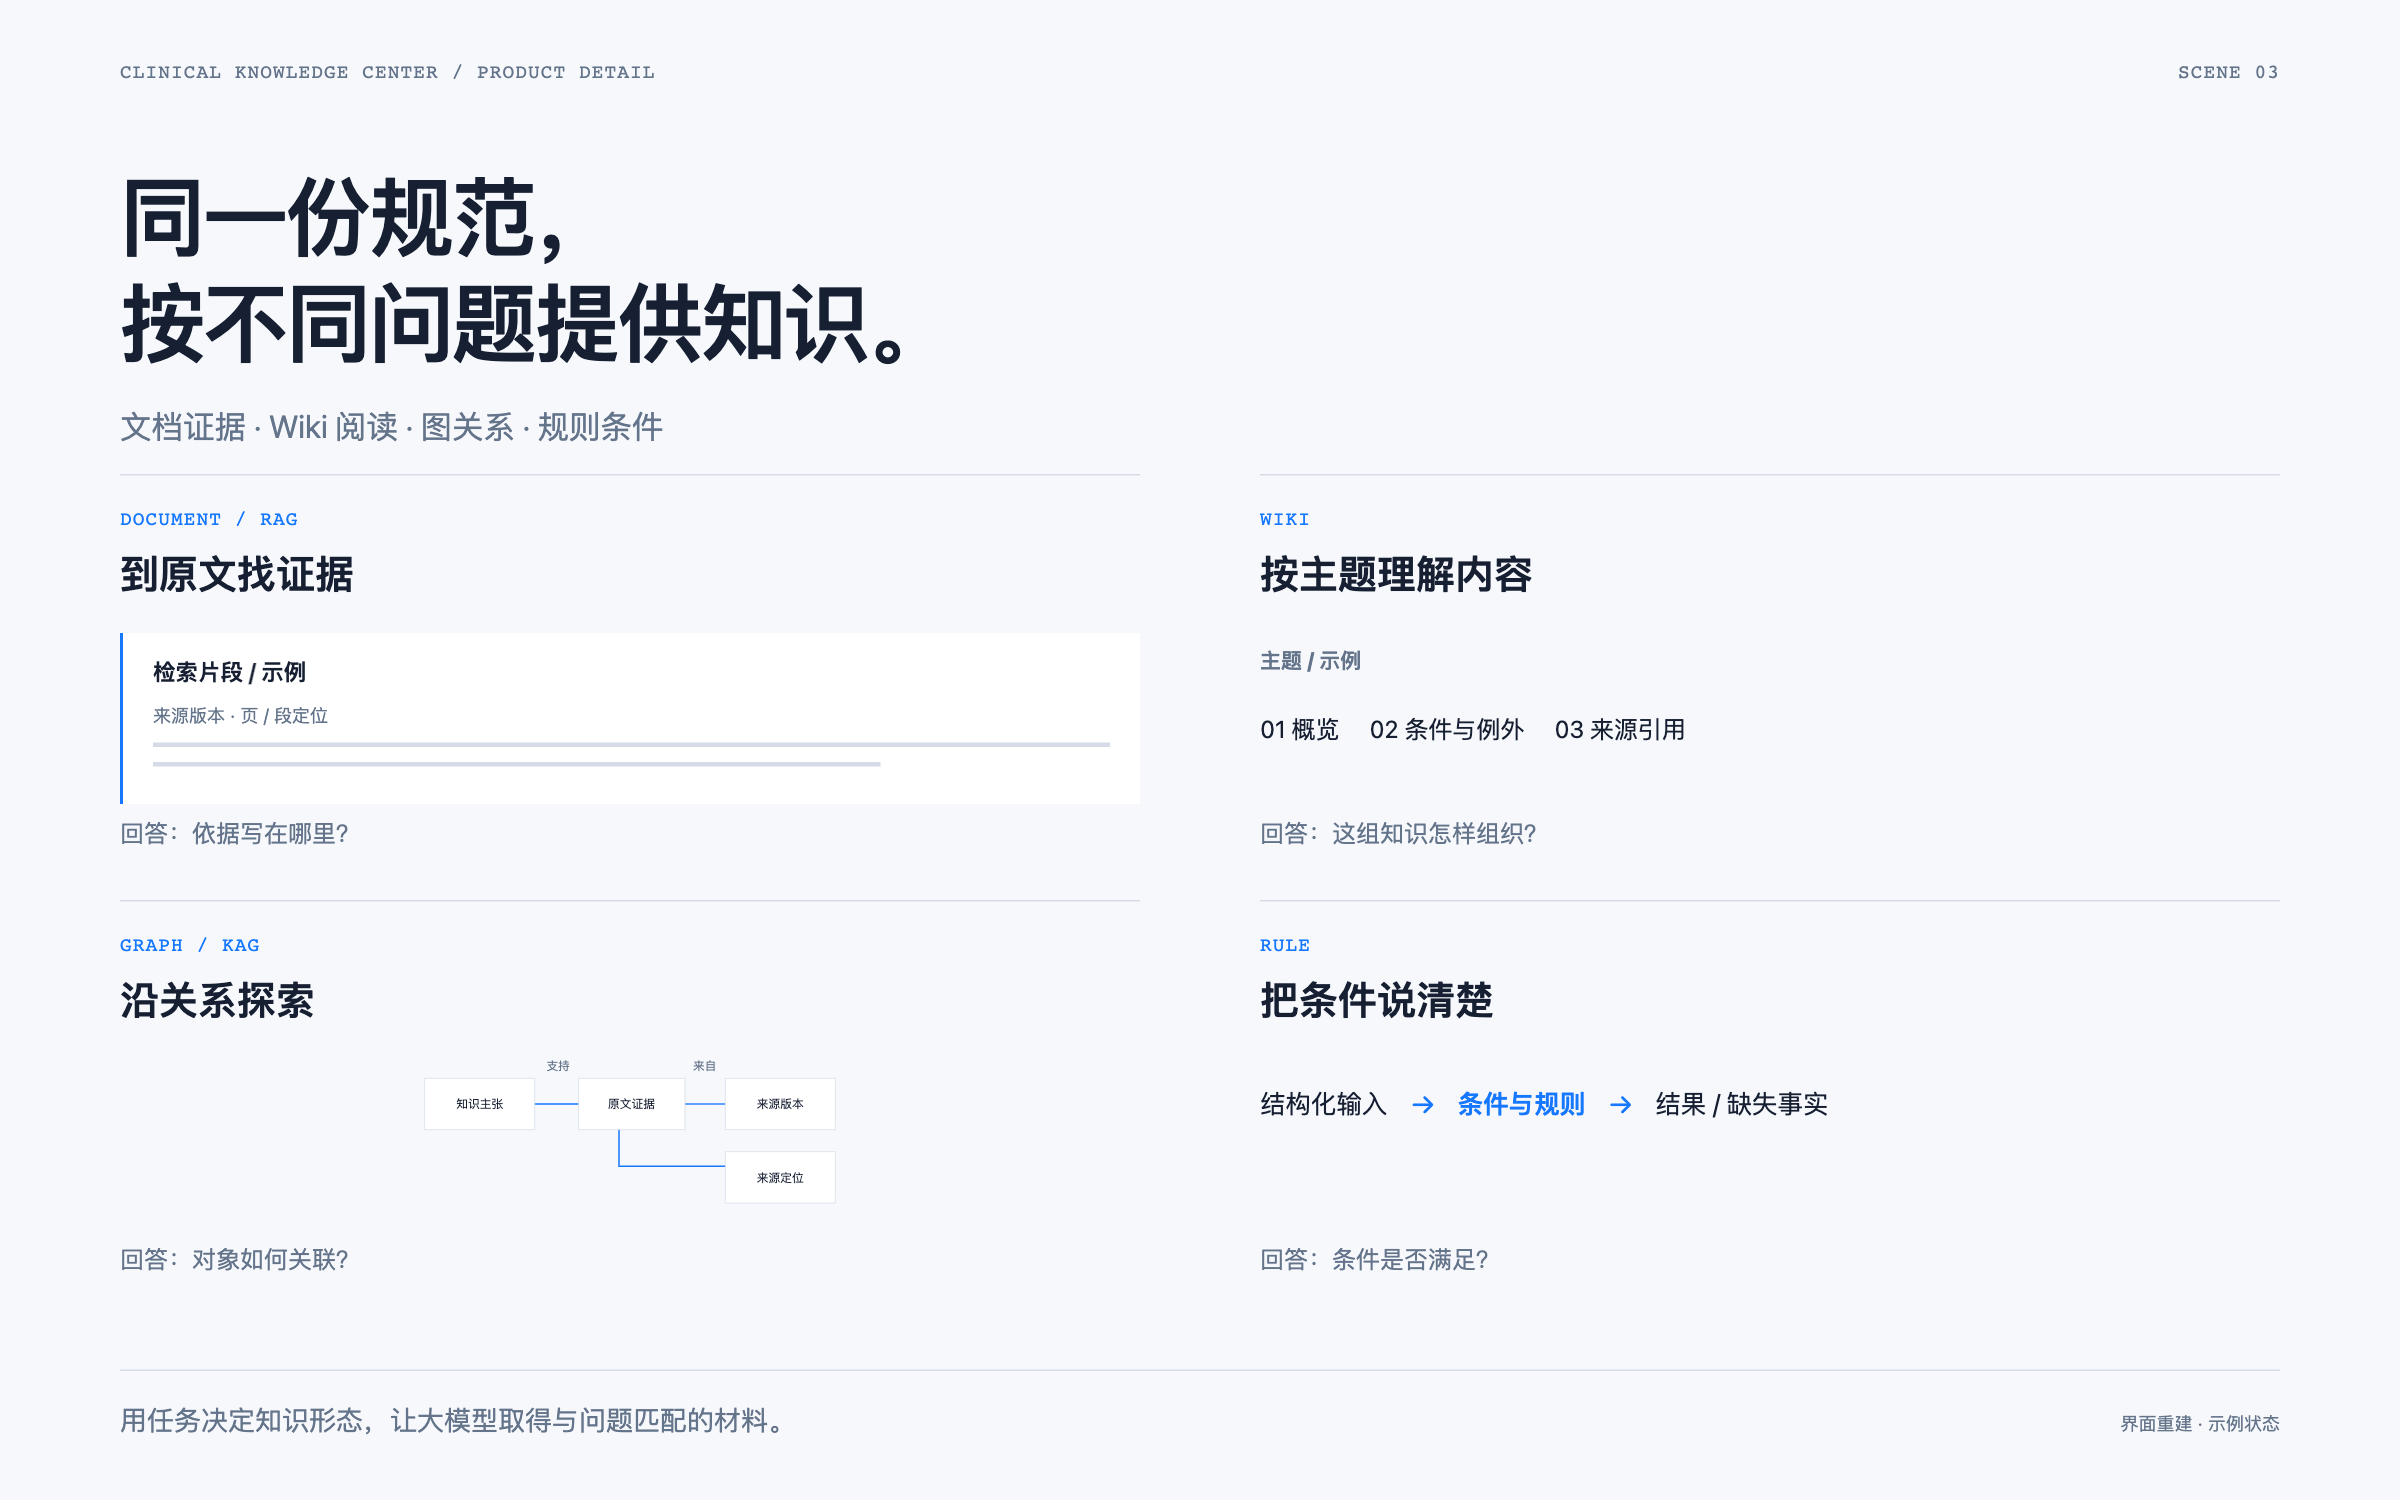
文档证据 · Wiki 阅读 · 图关系 · 规则条件
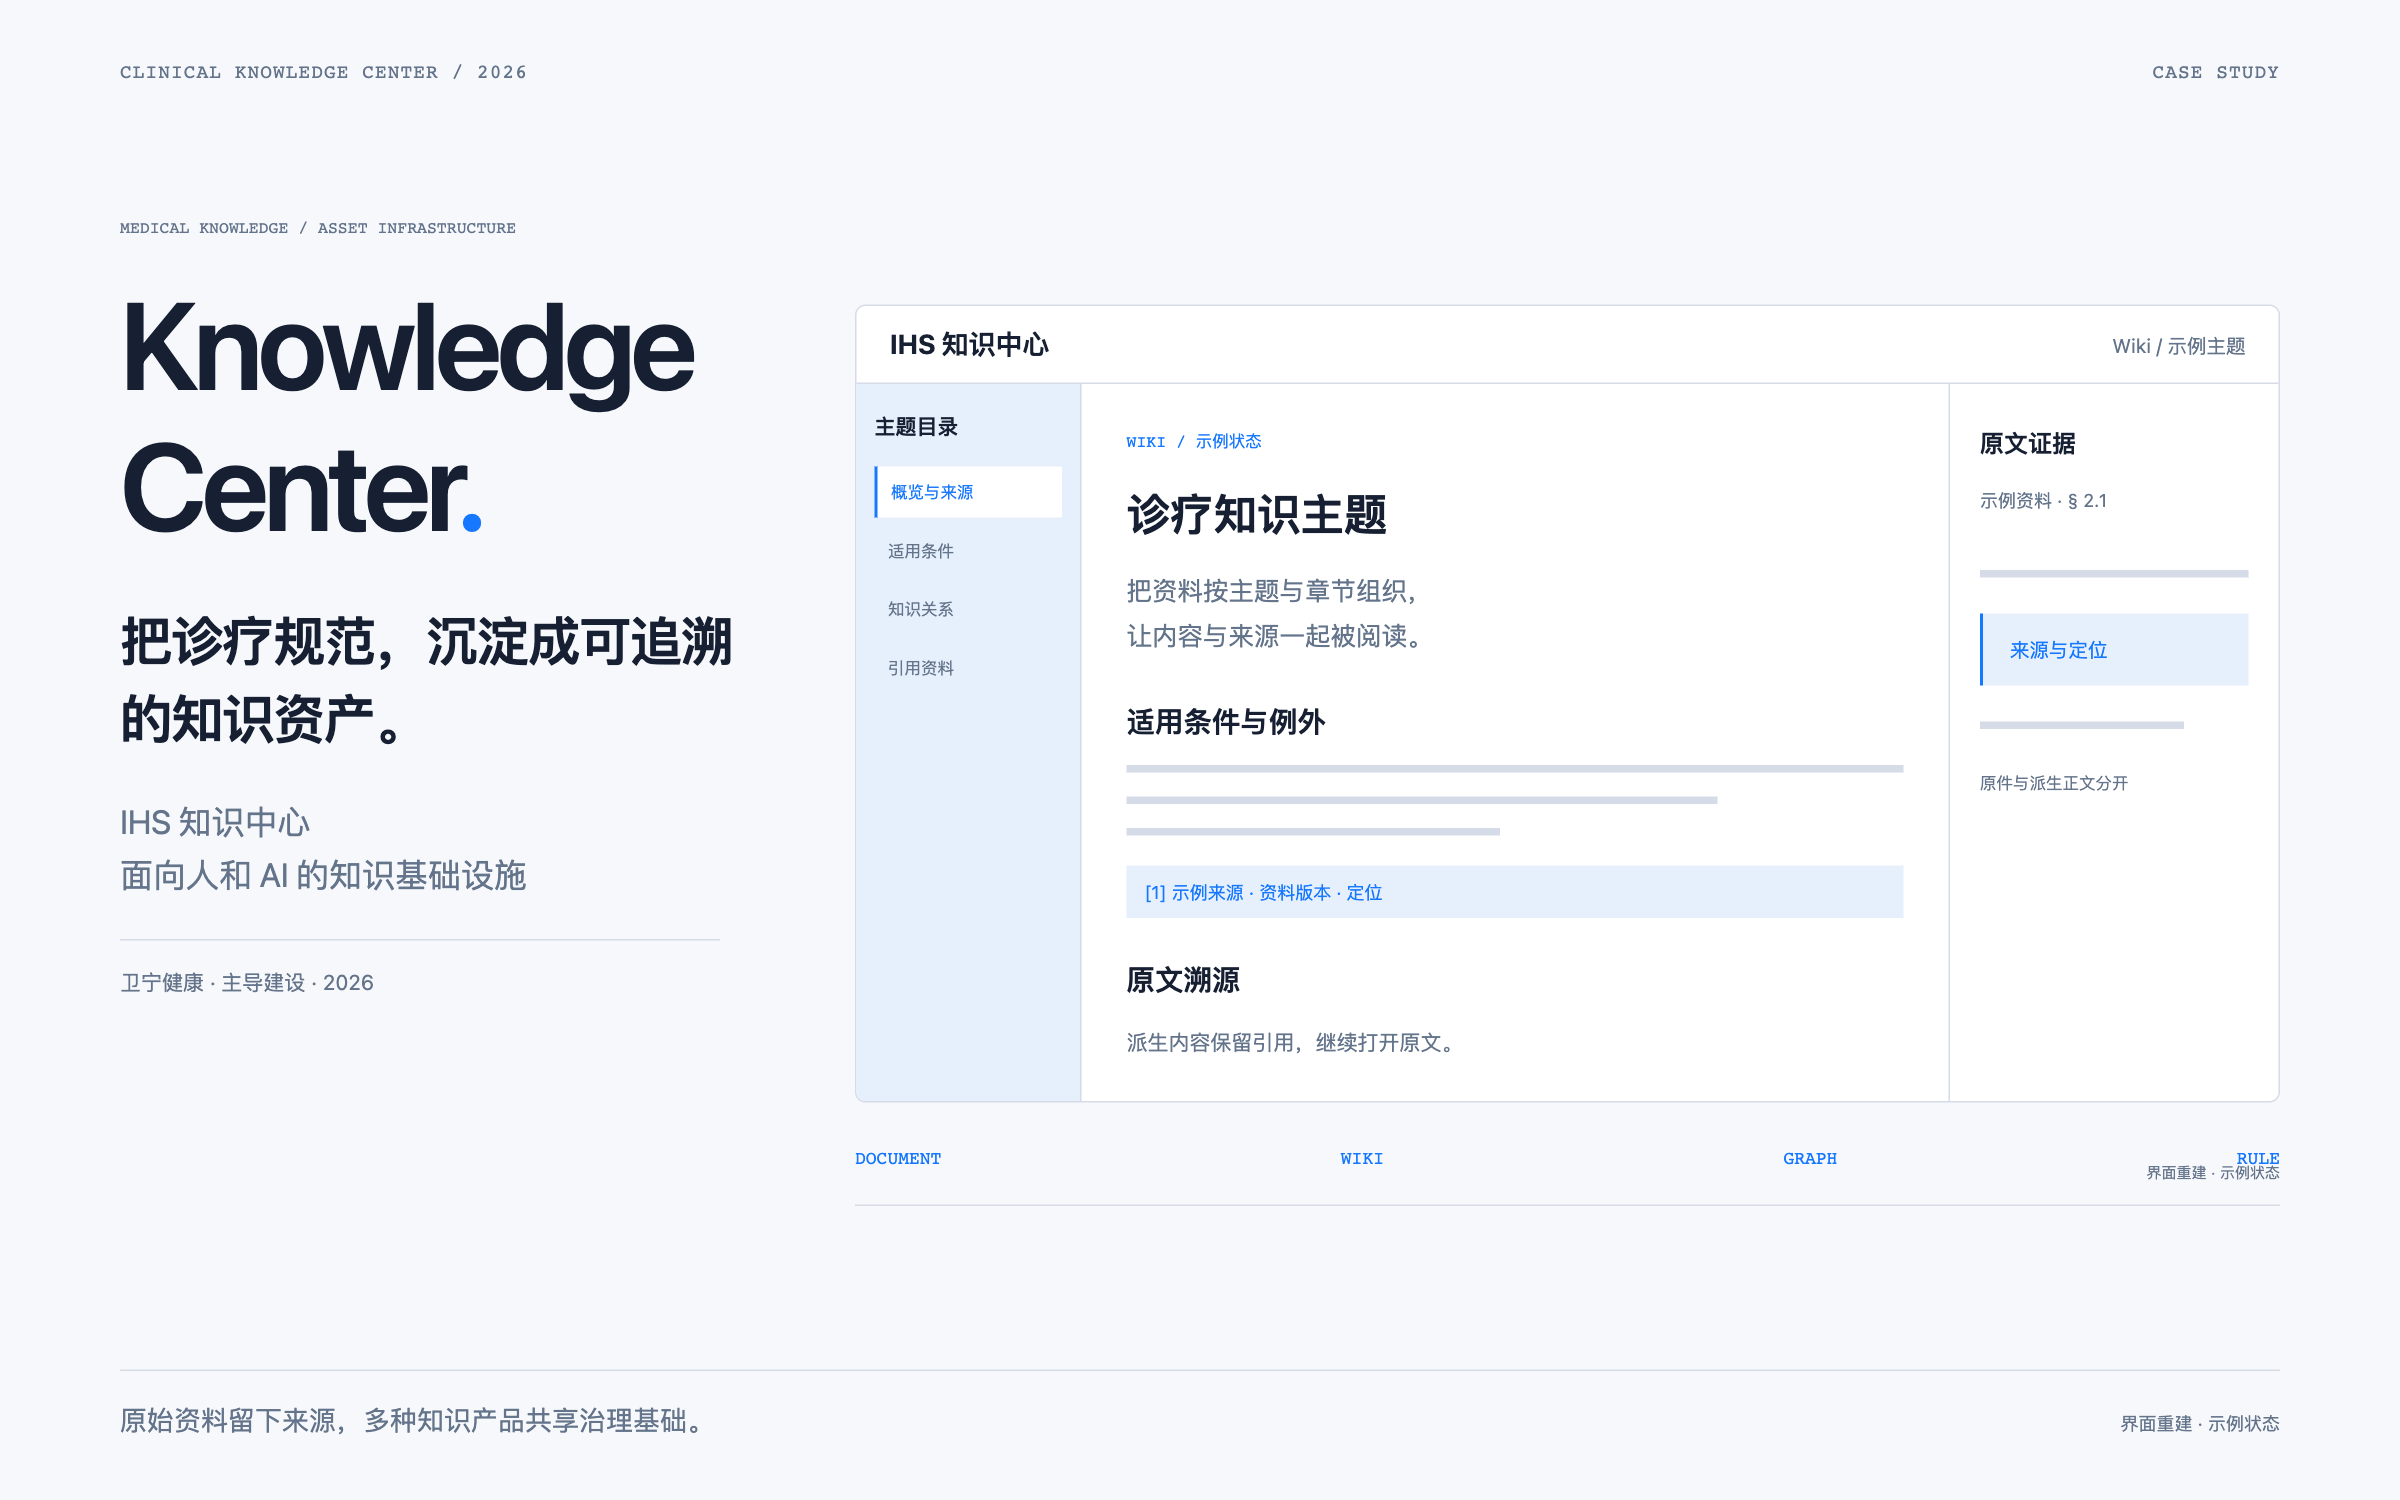
我把文档、Wiki、图和规则明确为不同知识产品。文档帮助寻找原文片段,Wiki组织主题阅读,图支持关系与路径探索,规则承载结构化条件判断。它们有各自的消费方式,共享来源治理;Wiki也不替代原始证据。
编辑与发布
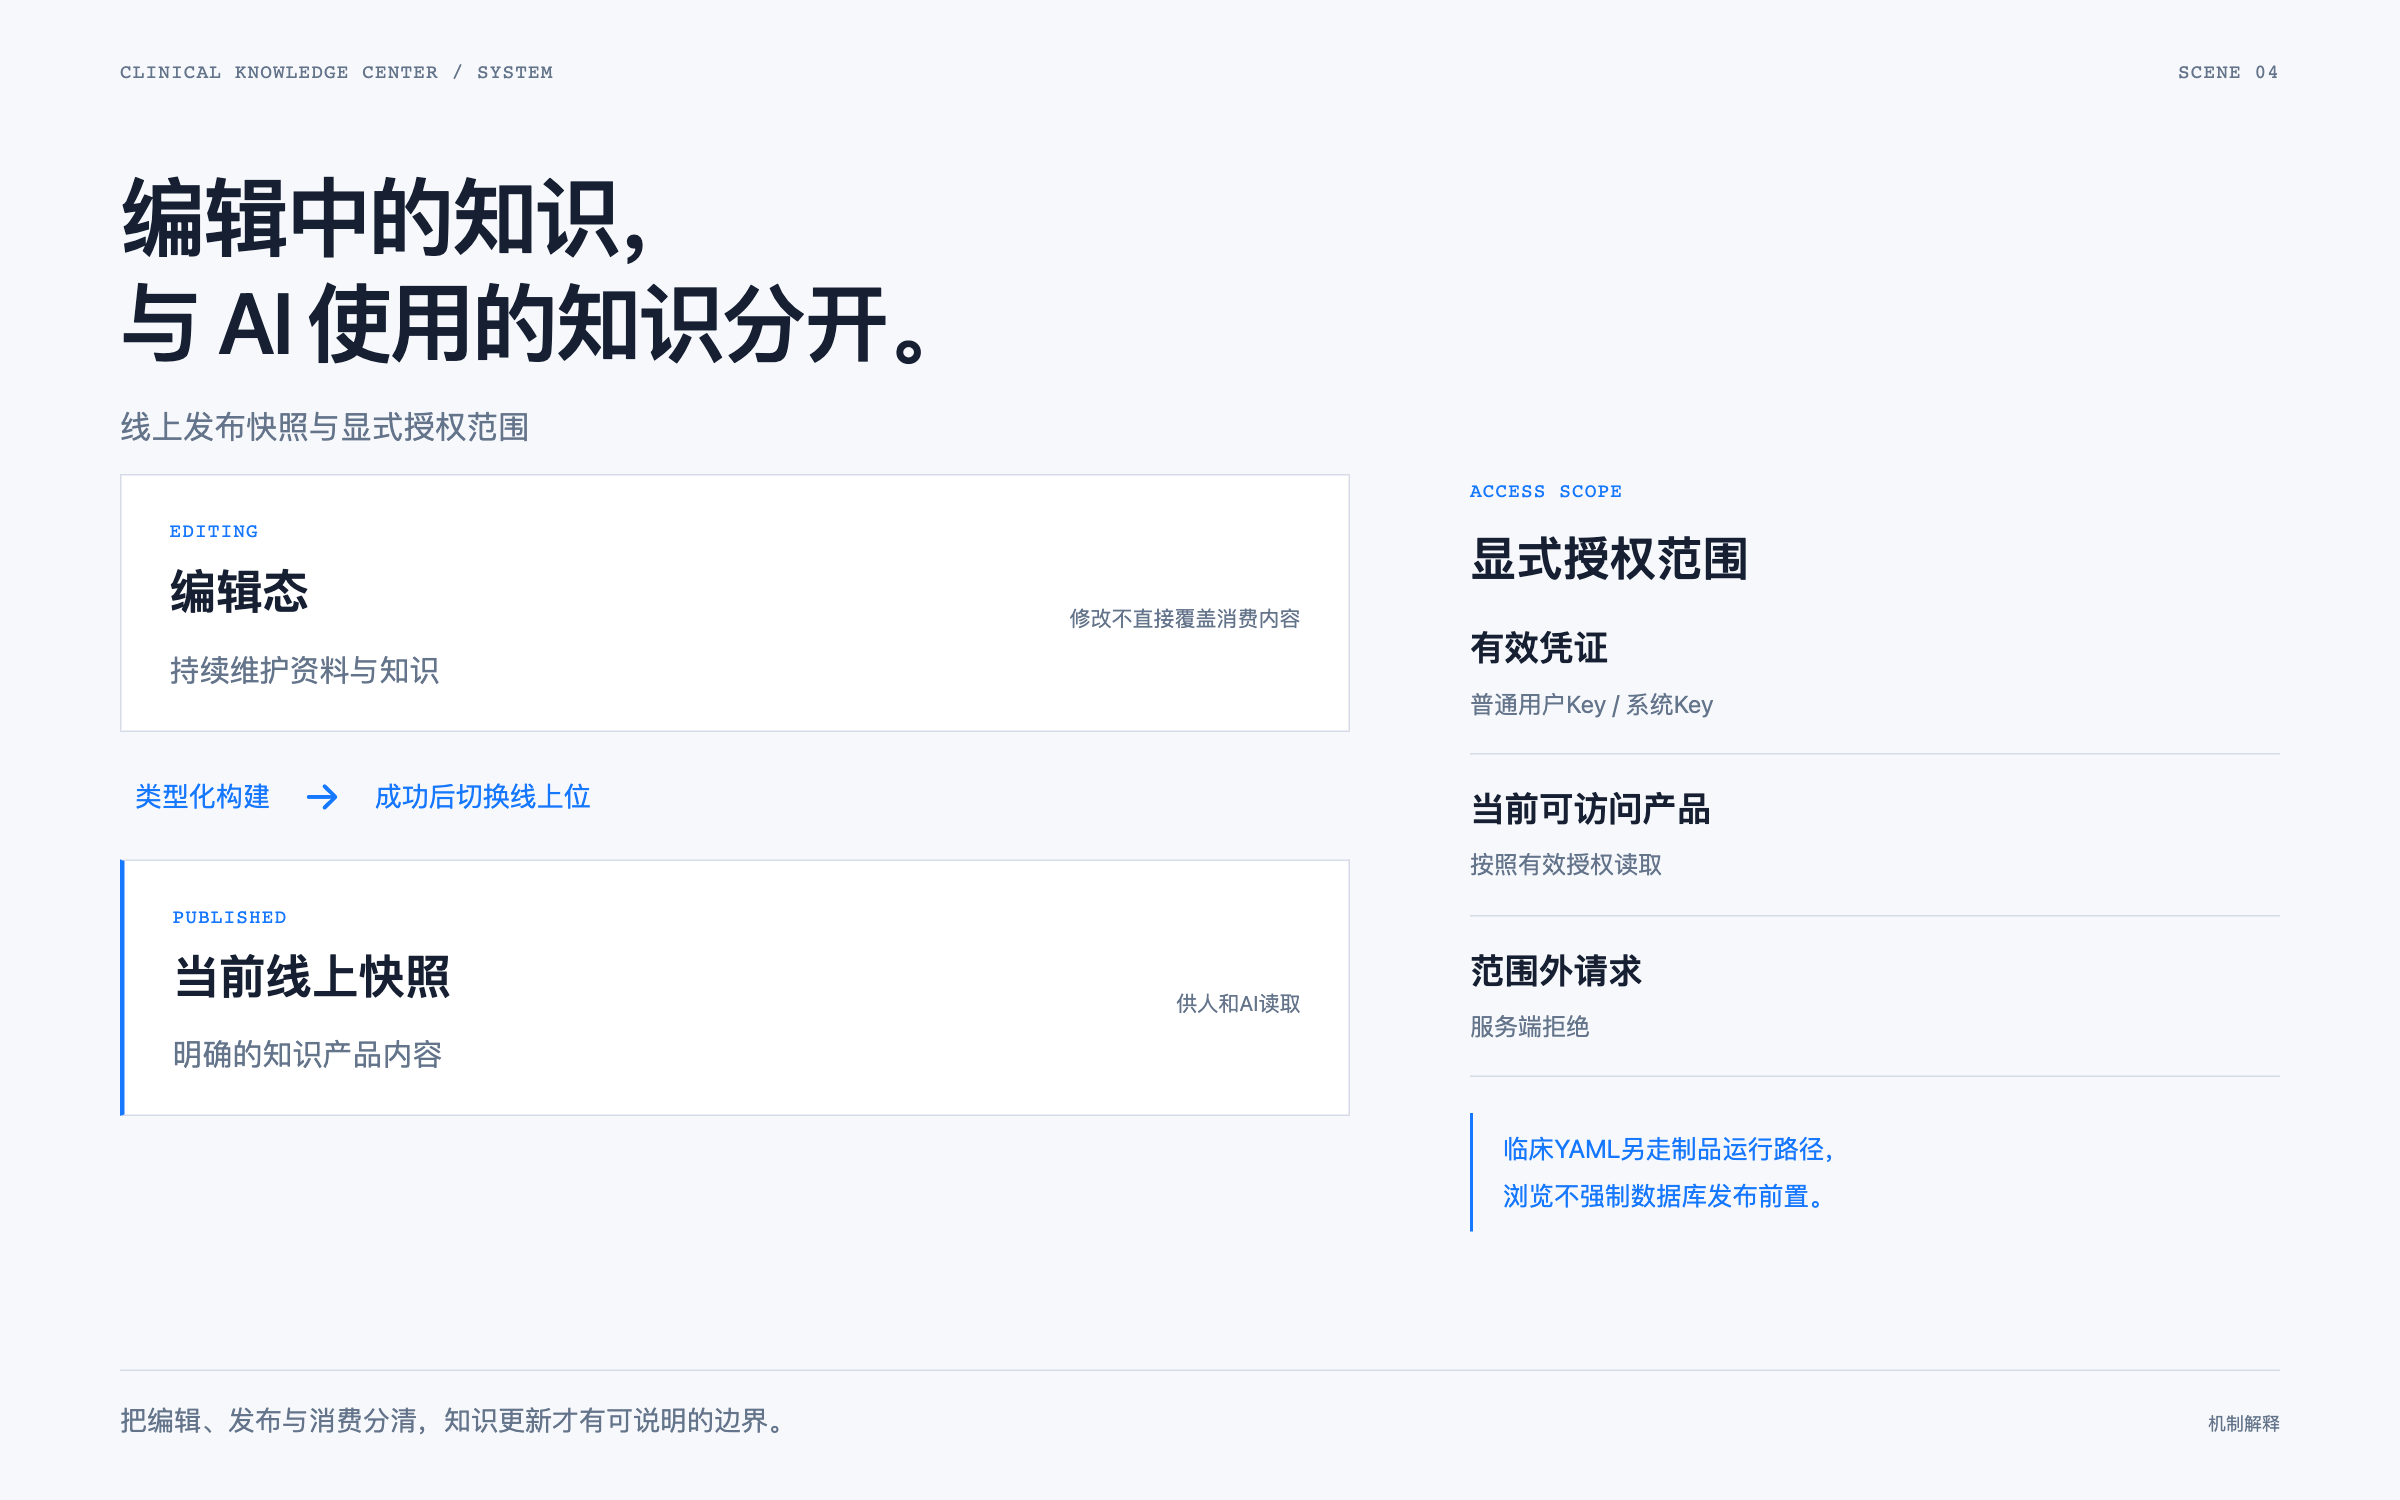
线上发布快照与显式授权范围
我推进单一线上发布位和类型化快照,重新发布成功后才切换消费内容;外部使用再由凭证和有效授权范围限定。管理端可以持续编辑,消费者读取明确的已发布内容。临床 YAML 浏览则保留随应用制品运行的独立路径,不强行加一套数据库发布前置。
来源和 ID 的核对
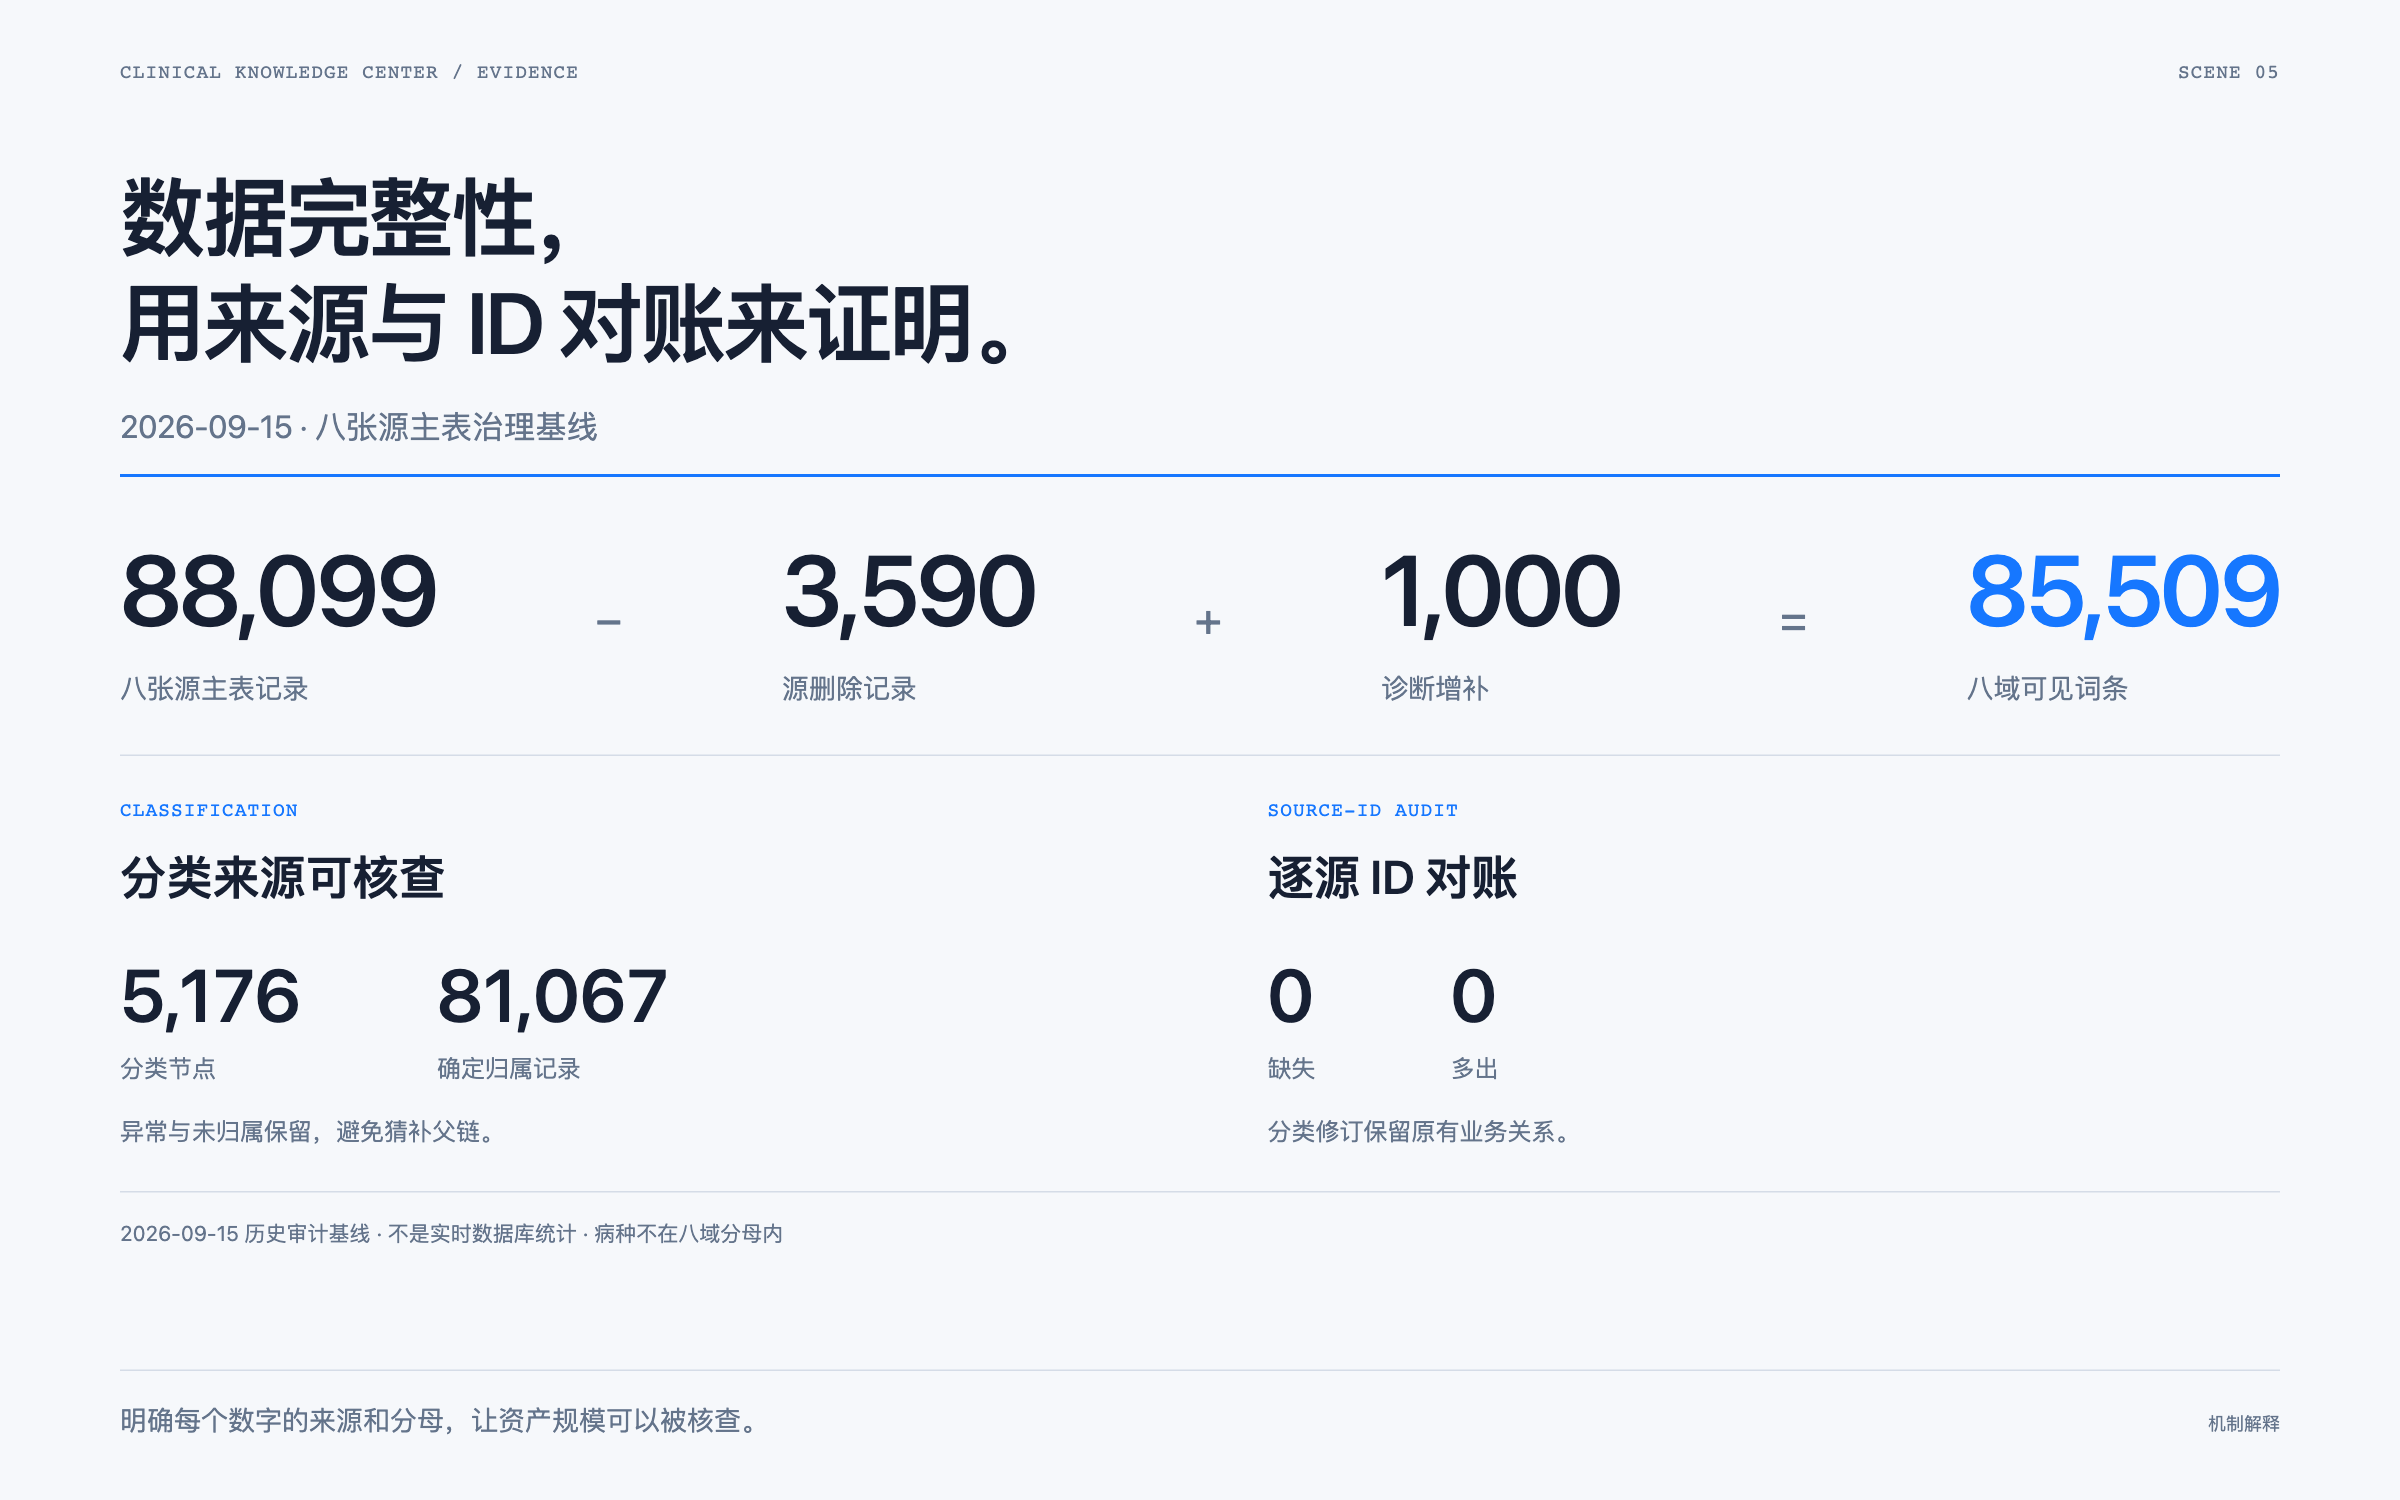
2026-09-15 · 八张源主表治理基线
八张源主表共有88,099条原始记录,源删除3,590条后保留84,509条可见记录;诊断另有1,000条补充,形成85,509条八域可见词条。分类投影形成5,176个节点、81,067条确定归属。逐源ID的审计记录缺失0、多出0,分类修订保留原有业务关系。
现在的进展
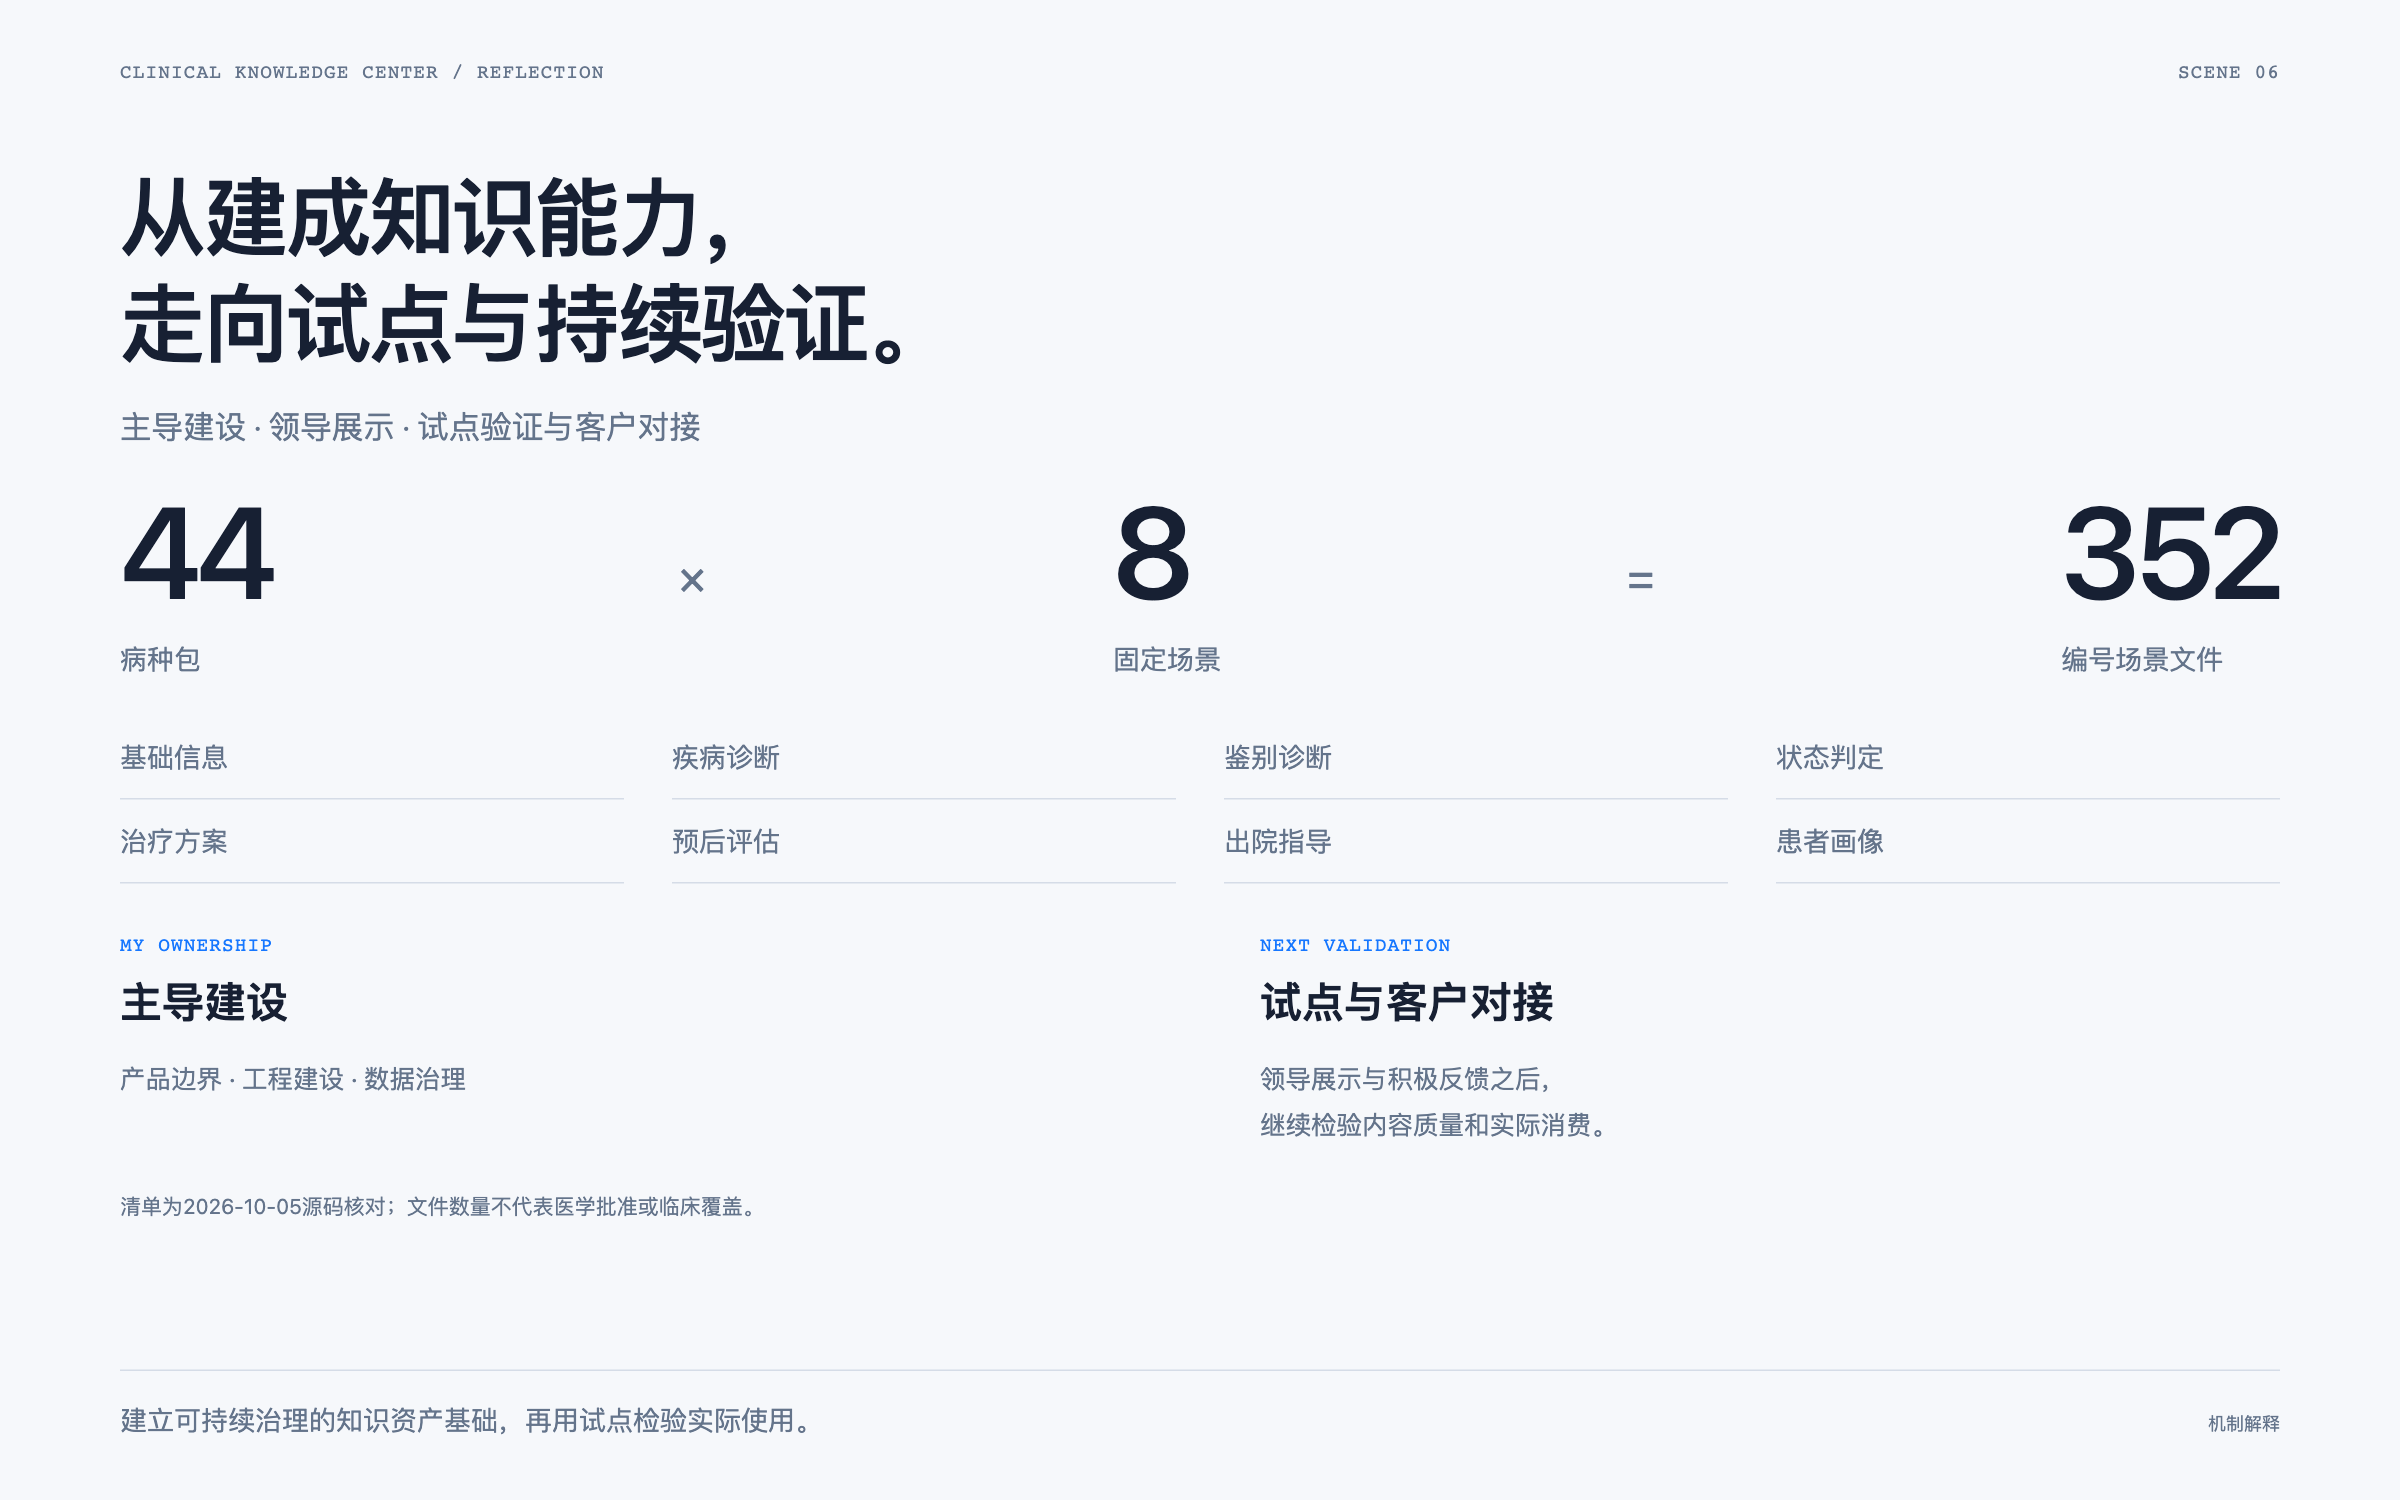
主导建设 · 领导展示 · 试点验证与客户对接
我主导知识中心的产品边界、工程建设和数据治理。当前内容目录包含44个病种包与352份八场景文件,支撑诊疗知识的组织与浏览。项目已向领导展示并获得积极反馈,正逐步推进试点验证与客户对接;内容结构、医学审核和实际使用效果分别验证。
我负责的部分
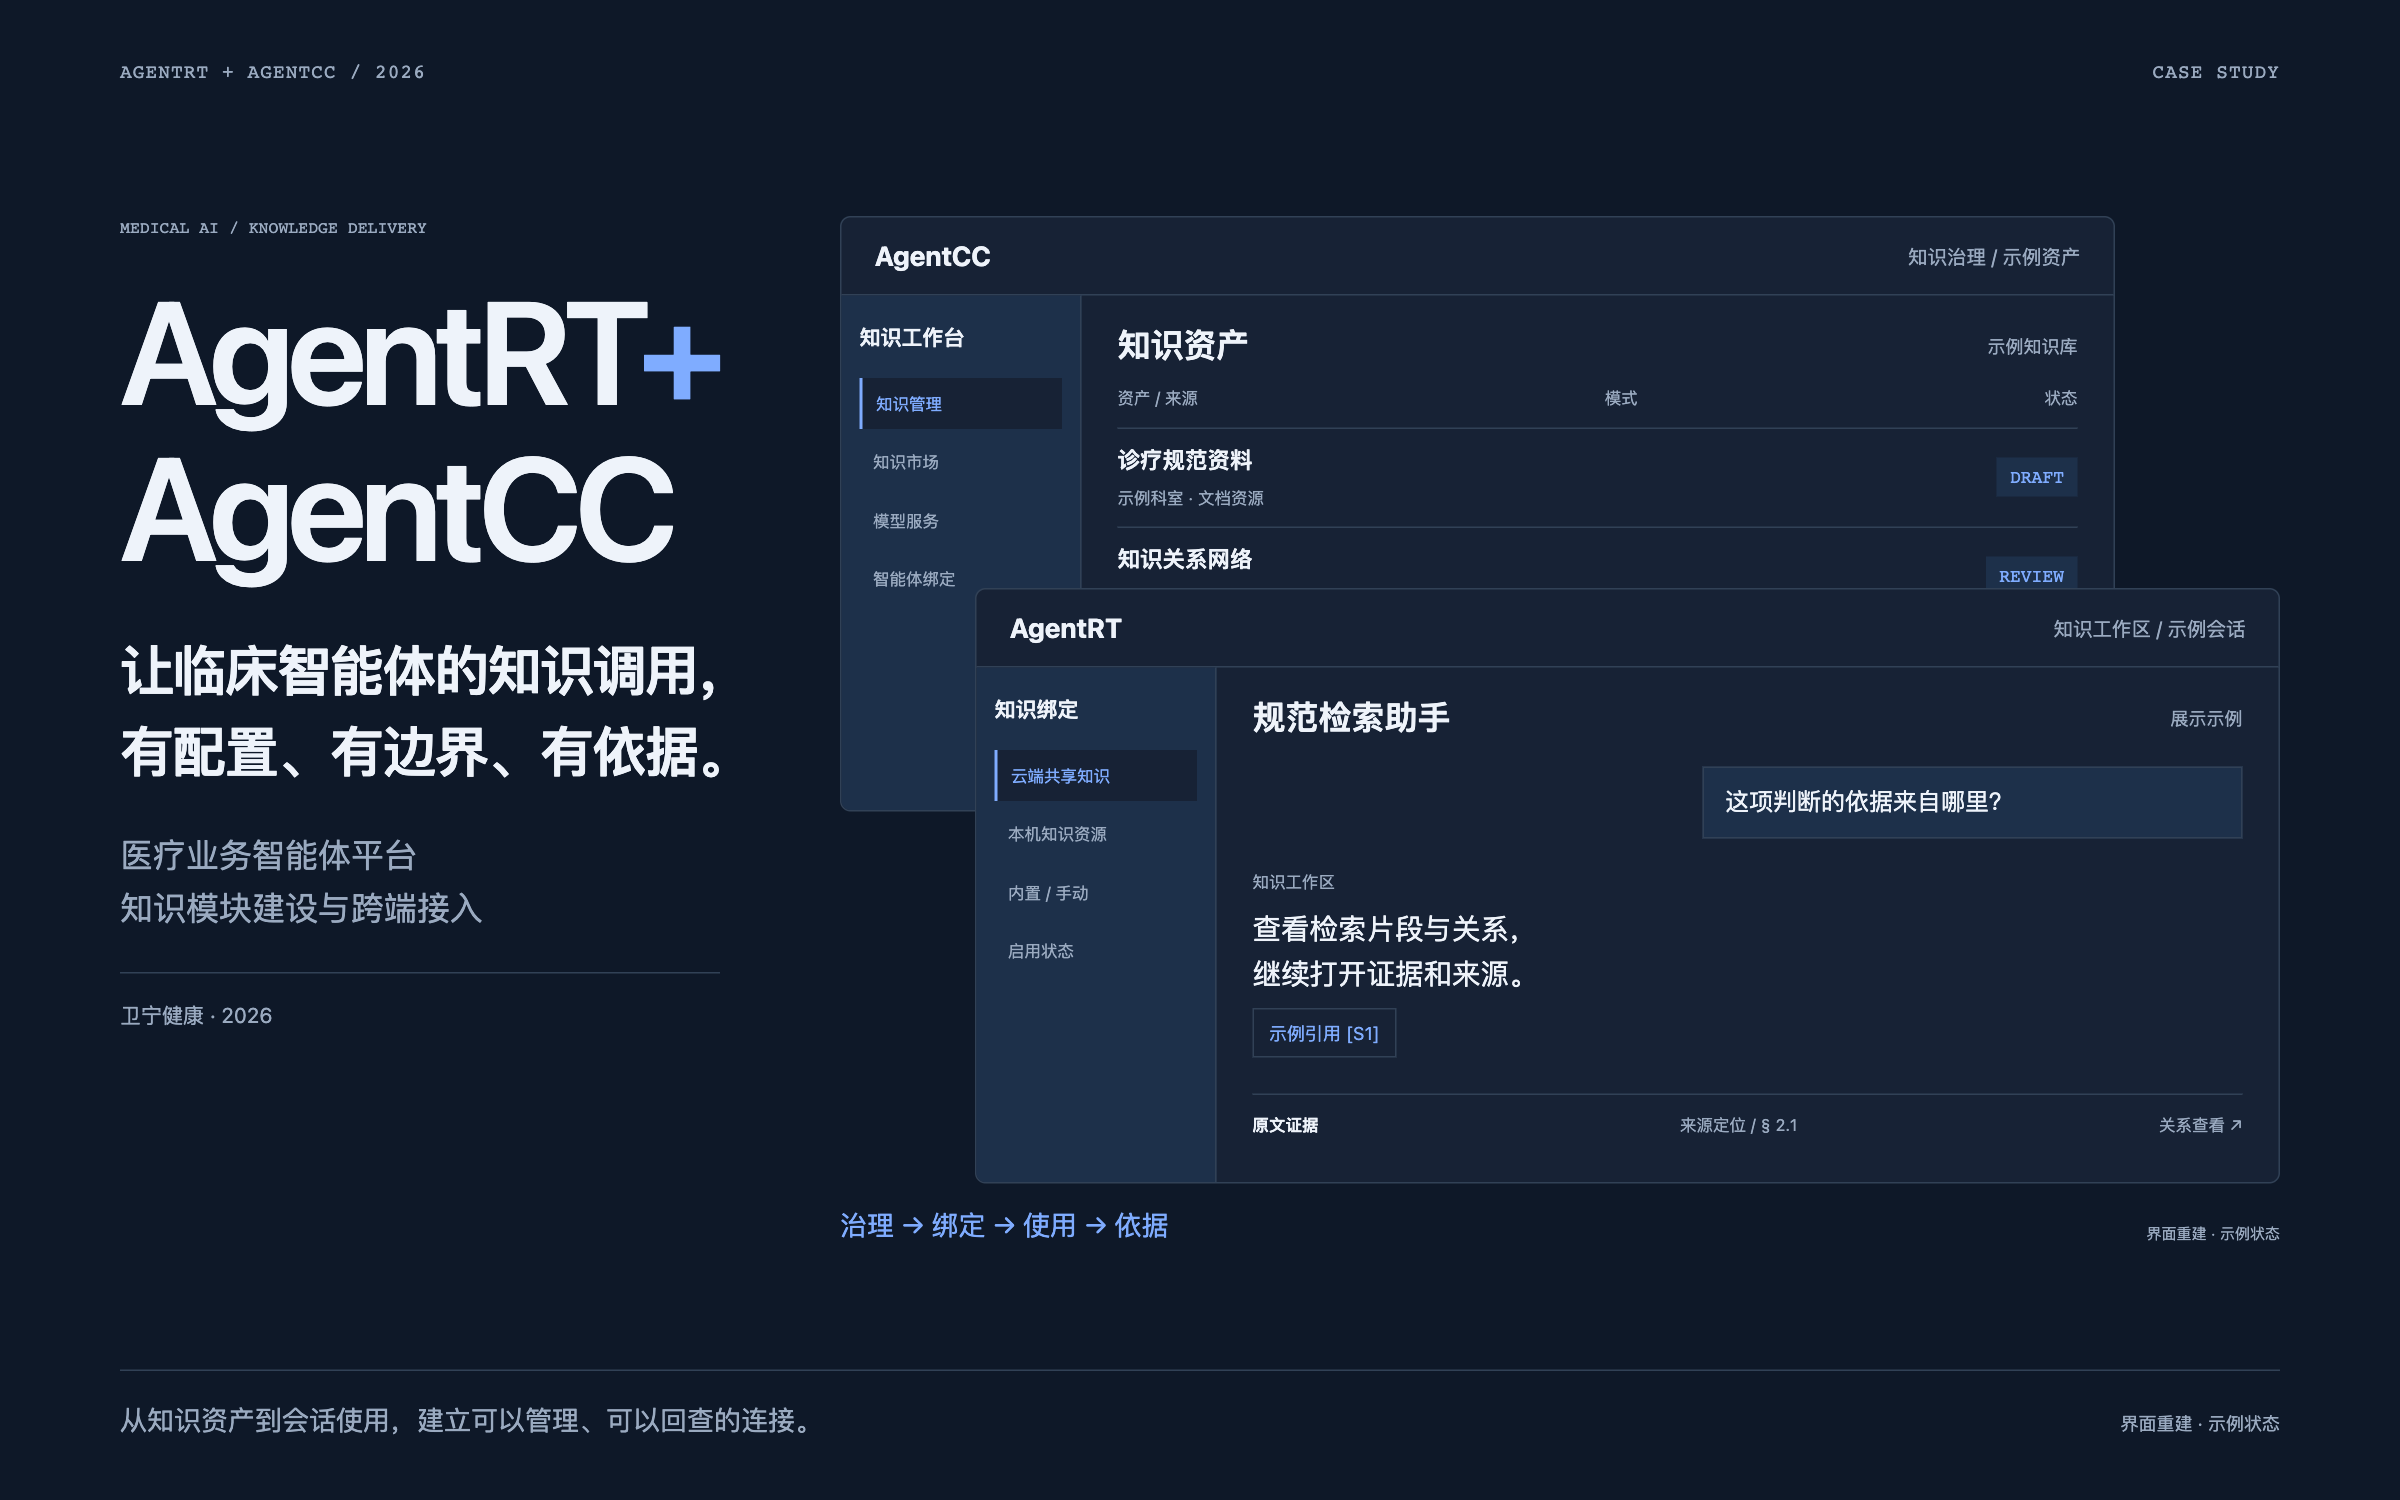
我主导知识中心建设,覆盖产品边界、前后端工程、资料/语料组织、知识产品、发布与消费契约,以及真实字典数据治理。重点是让原先分散在智能体产品里的知识能力,形成独立可维护和可复用的资产体系。
案例视觉采用脱敏界面与机制重建,示例状态、引用与对话用于解释。项目阶段按当前工作进展说明;来源追溯、内容规模和工程检查分别呈现。