关键词很多,先看哪些?
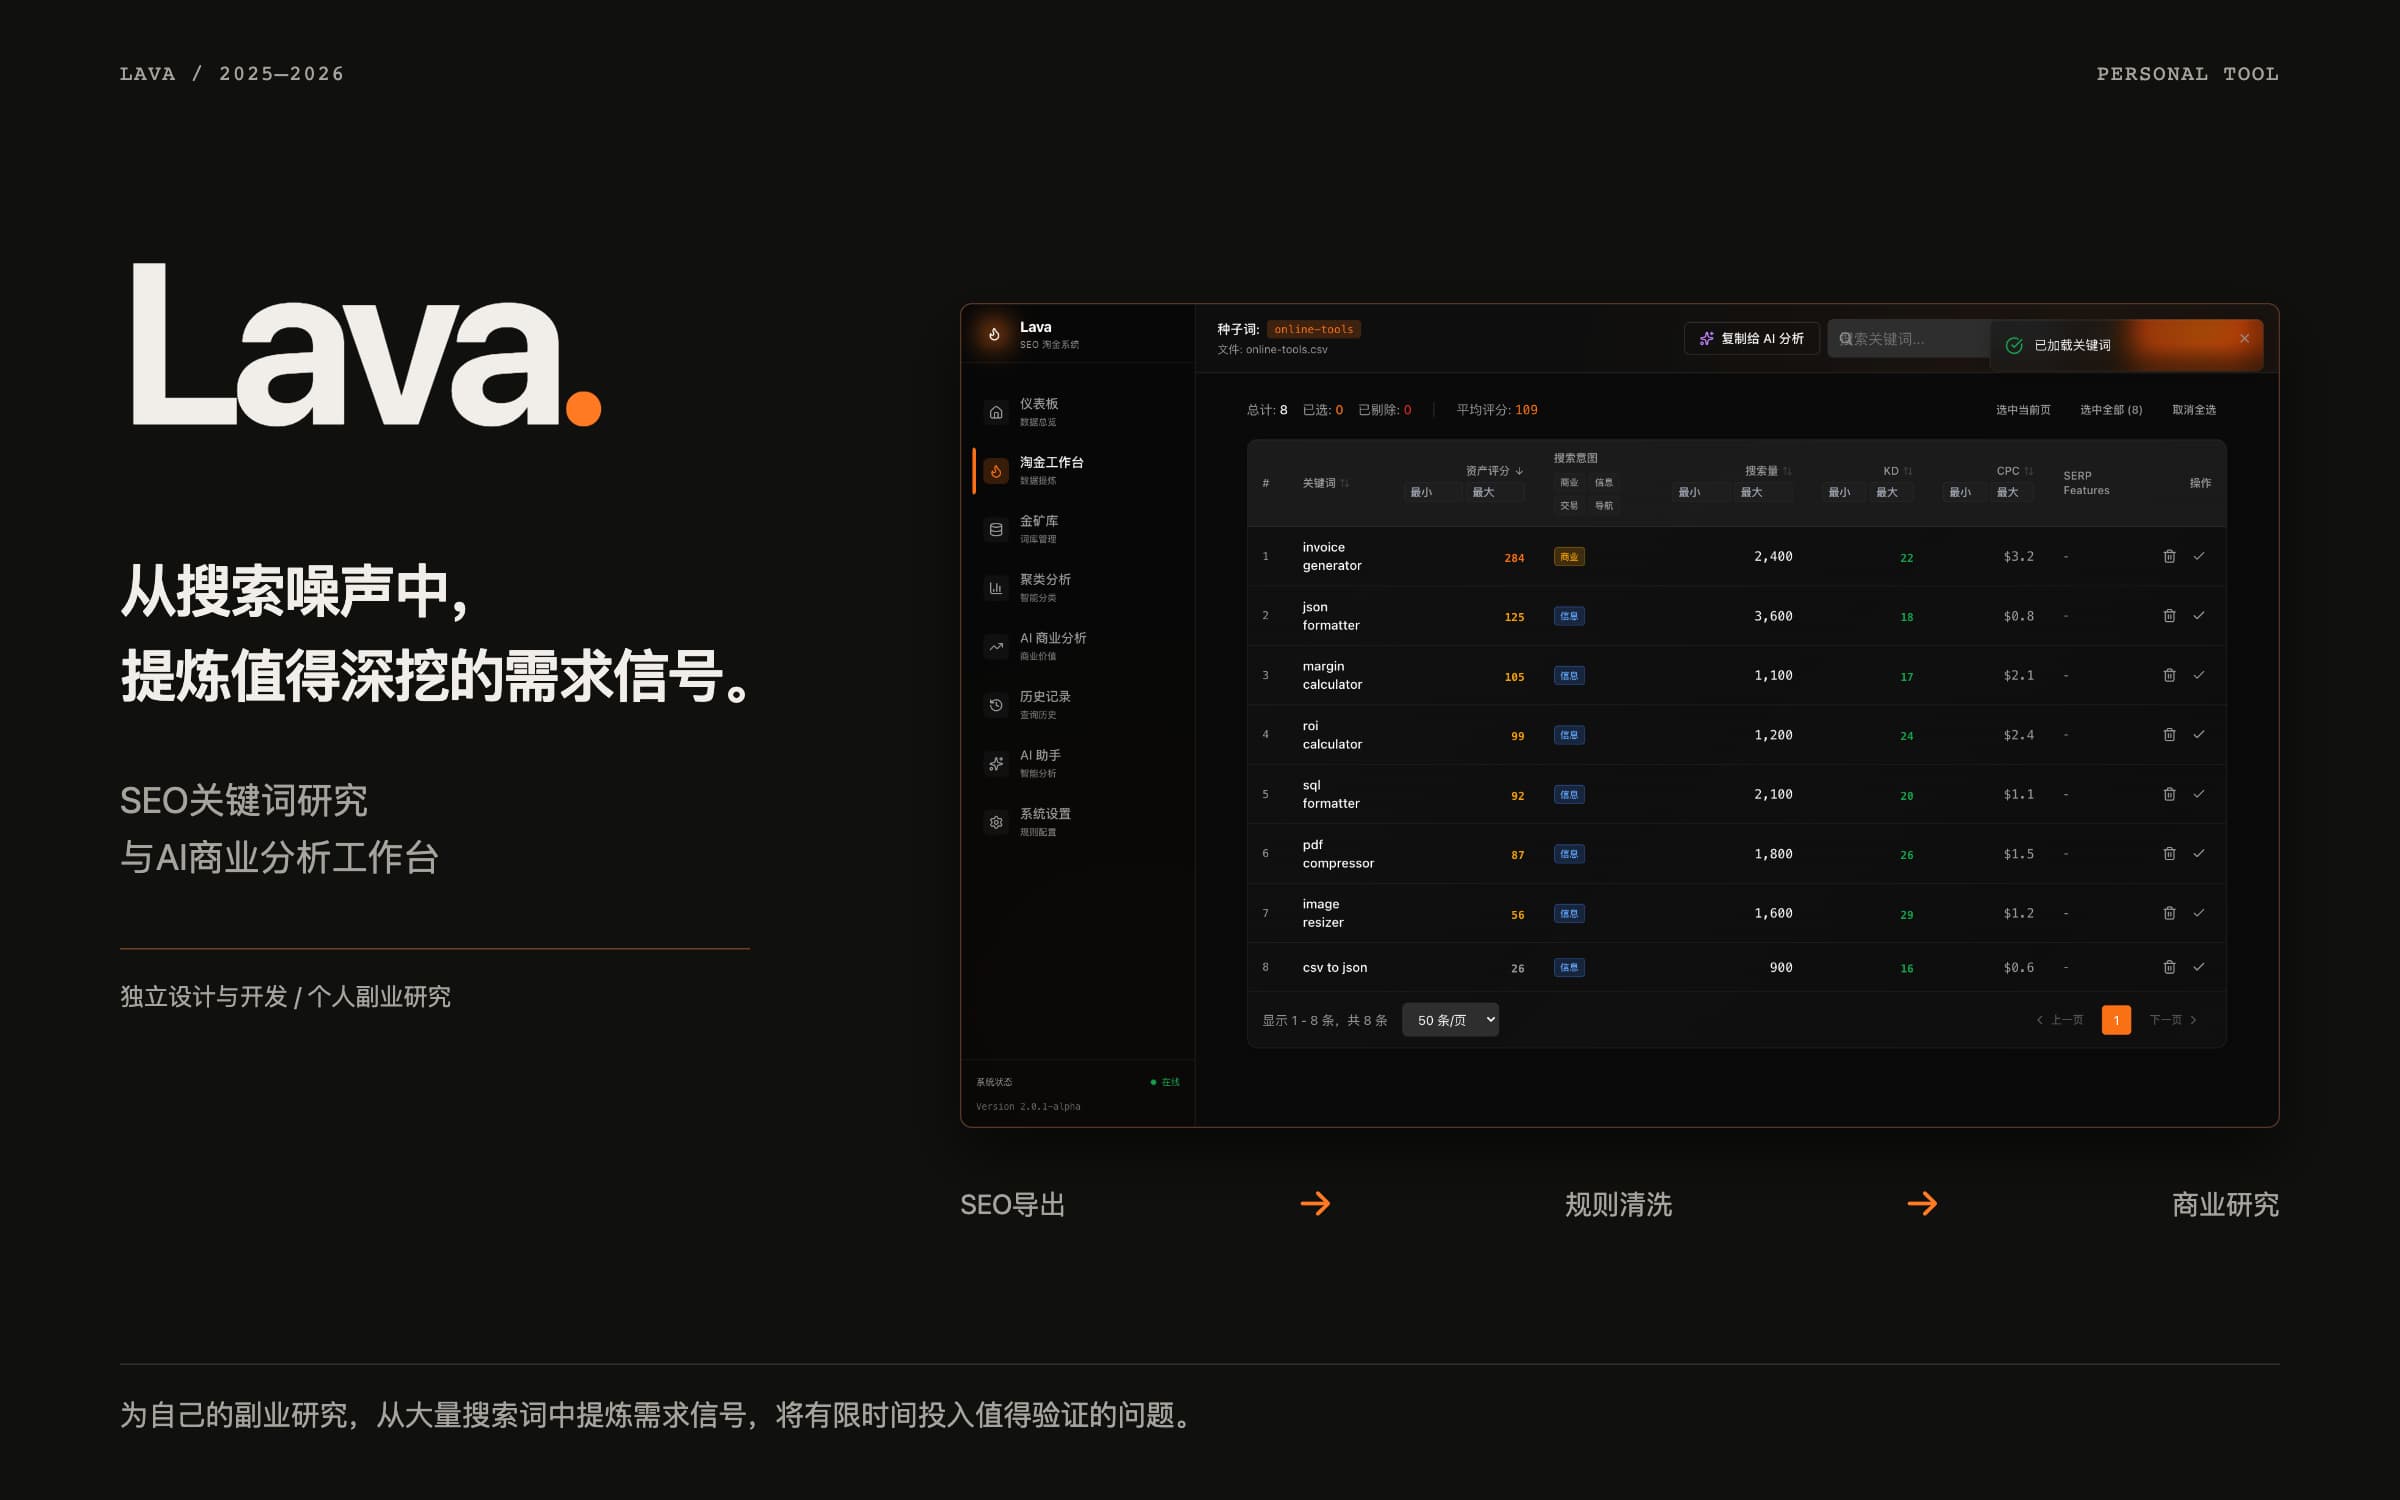
每次拿到 SEO 关键词数据,我都需要完成同一步工作:从搜索行为中找出可能值得投入的需求。关键词记录了人们在找什么,搜索量、难度和 CPC 提供研究线索,但它们不能直接回答:这些人愿不愿付费?会不会反复使用?这个问题是否适合我投入时间去做?
Lava 因此处在副业流程的前端。它的任务是形成值得继续研究的候选,而不是用一个分数替代最终商业决策。
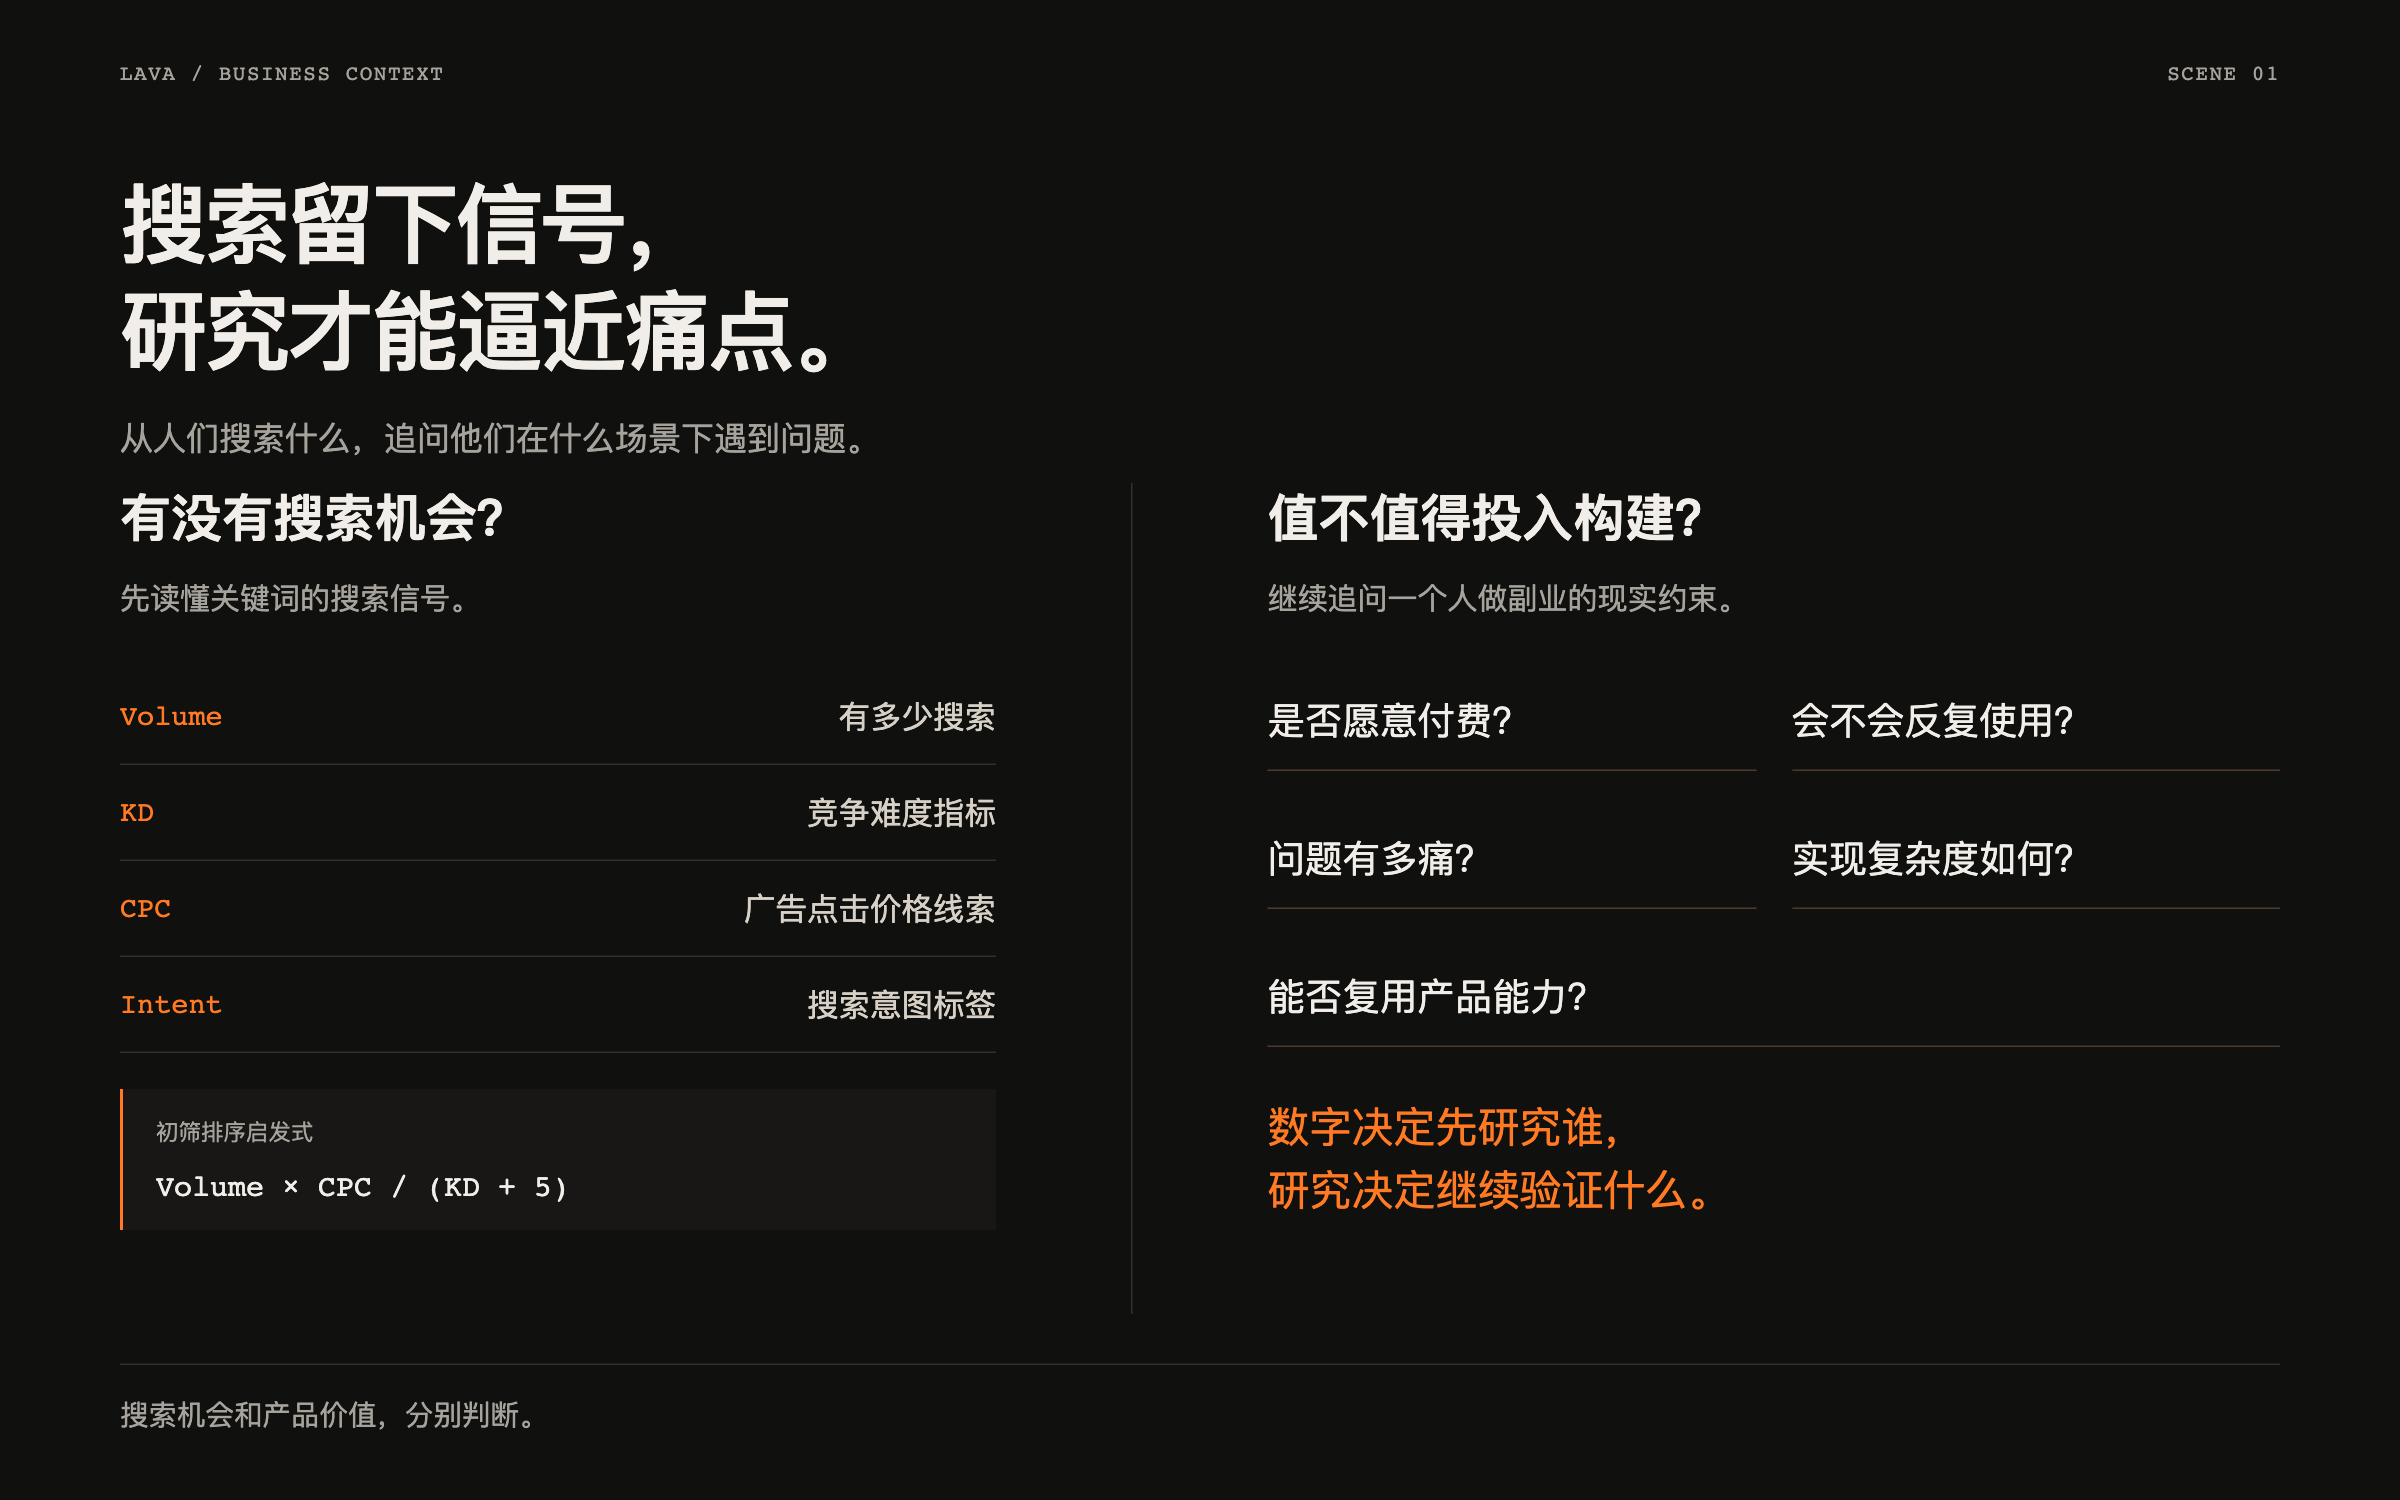
搜索量之外,还要问什么
一个低难度词可能只是一次性问题;一个搜索量很大的词也可能指向已有平台、实体商品或不适合自己的业务。反过来,标记为信息型的词也可能是用户在找一个具体工具。
清理的价值是让关键需求信号浮出来;深挖的价值是把“有人在搜索”推进为“谁在什么场景下被什么问题困住”的研究假设。真正需要处理的是两种不同的判断:先判断有没有搜索机会,再判断是否值得构建。把它们混在一个排行里,很容易选出数字漂亮、却不适合投入的方向。
筛选规则和例外
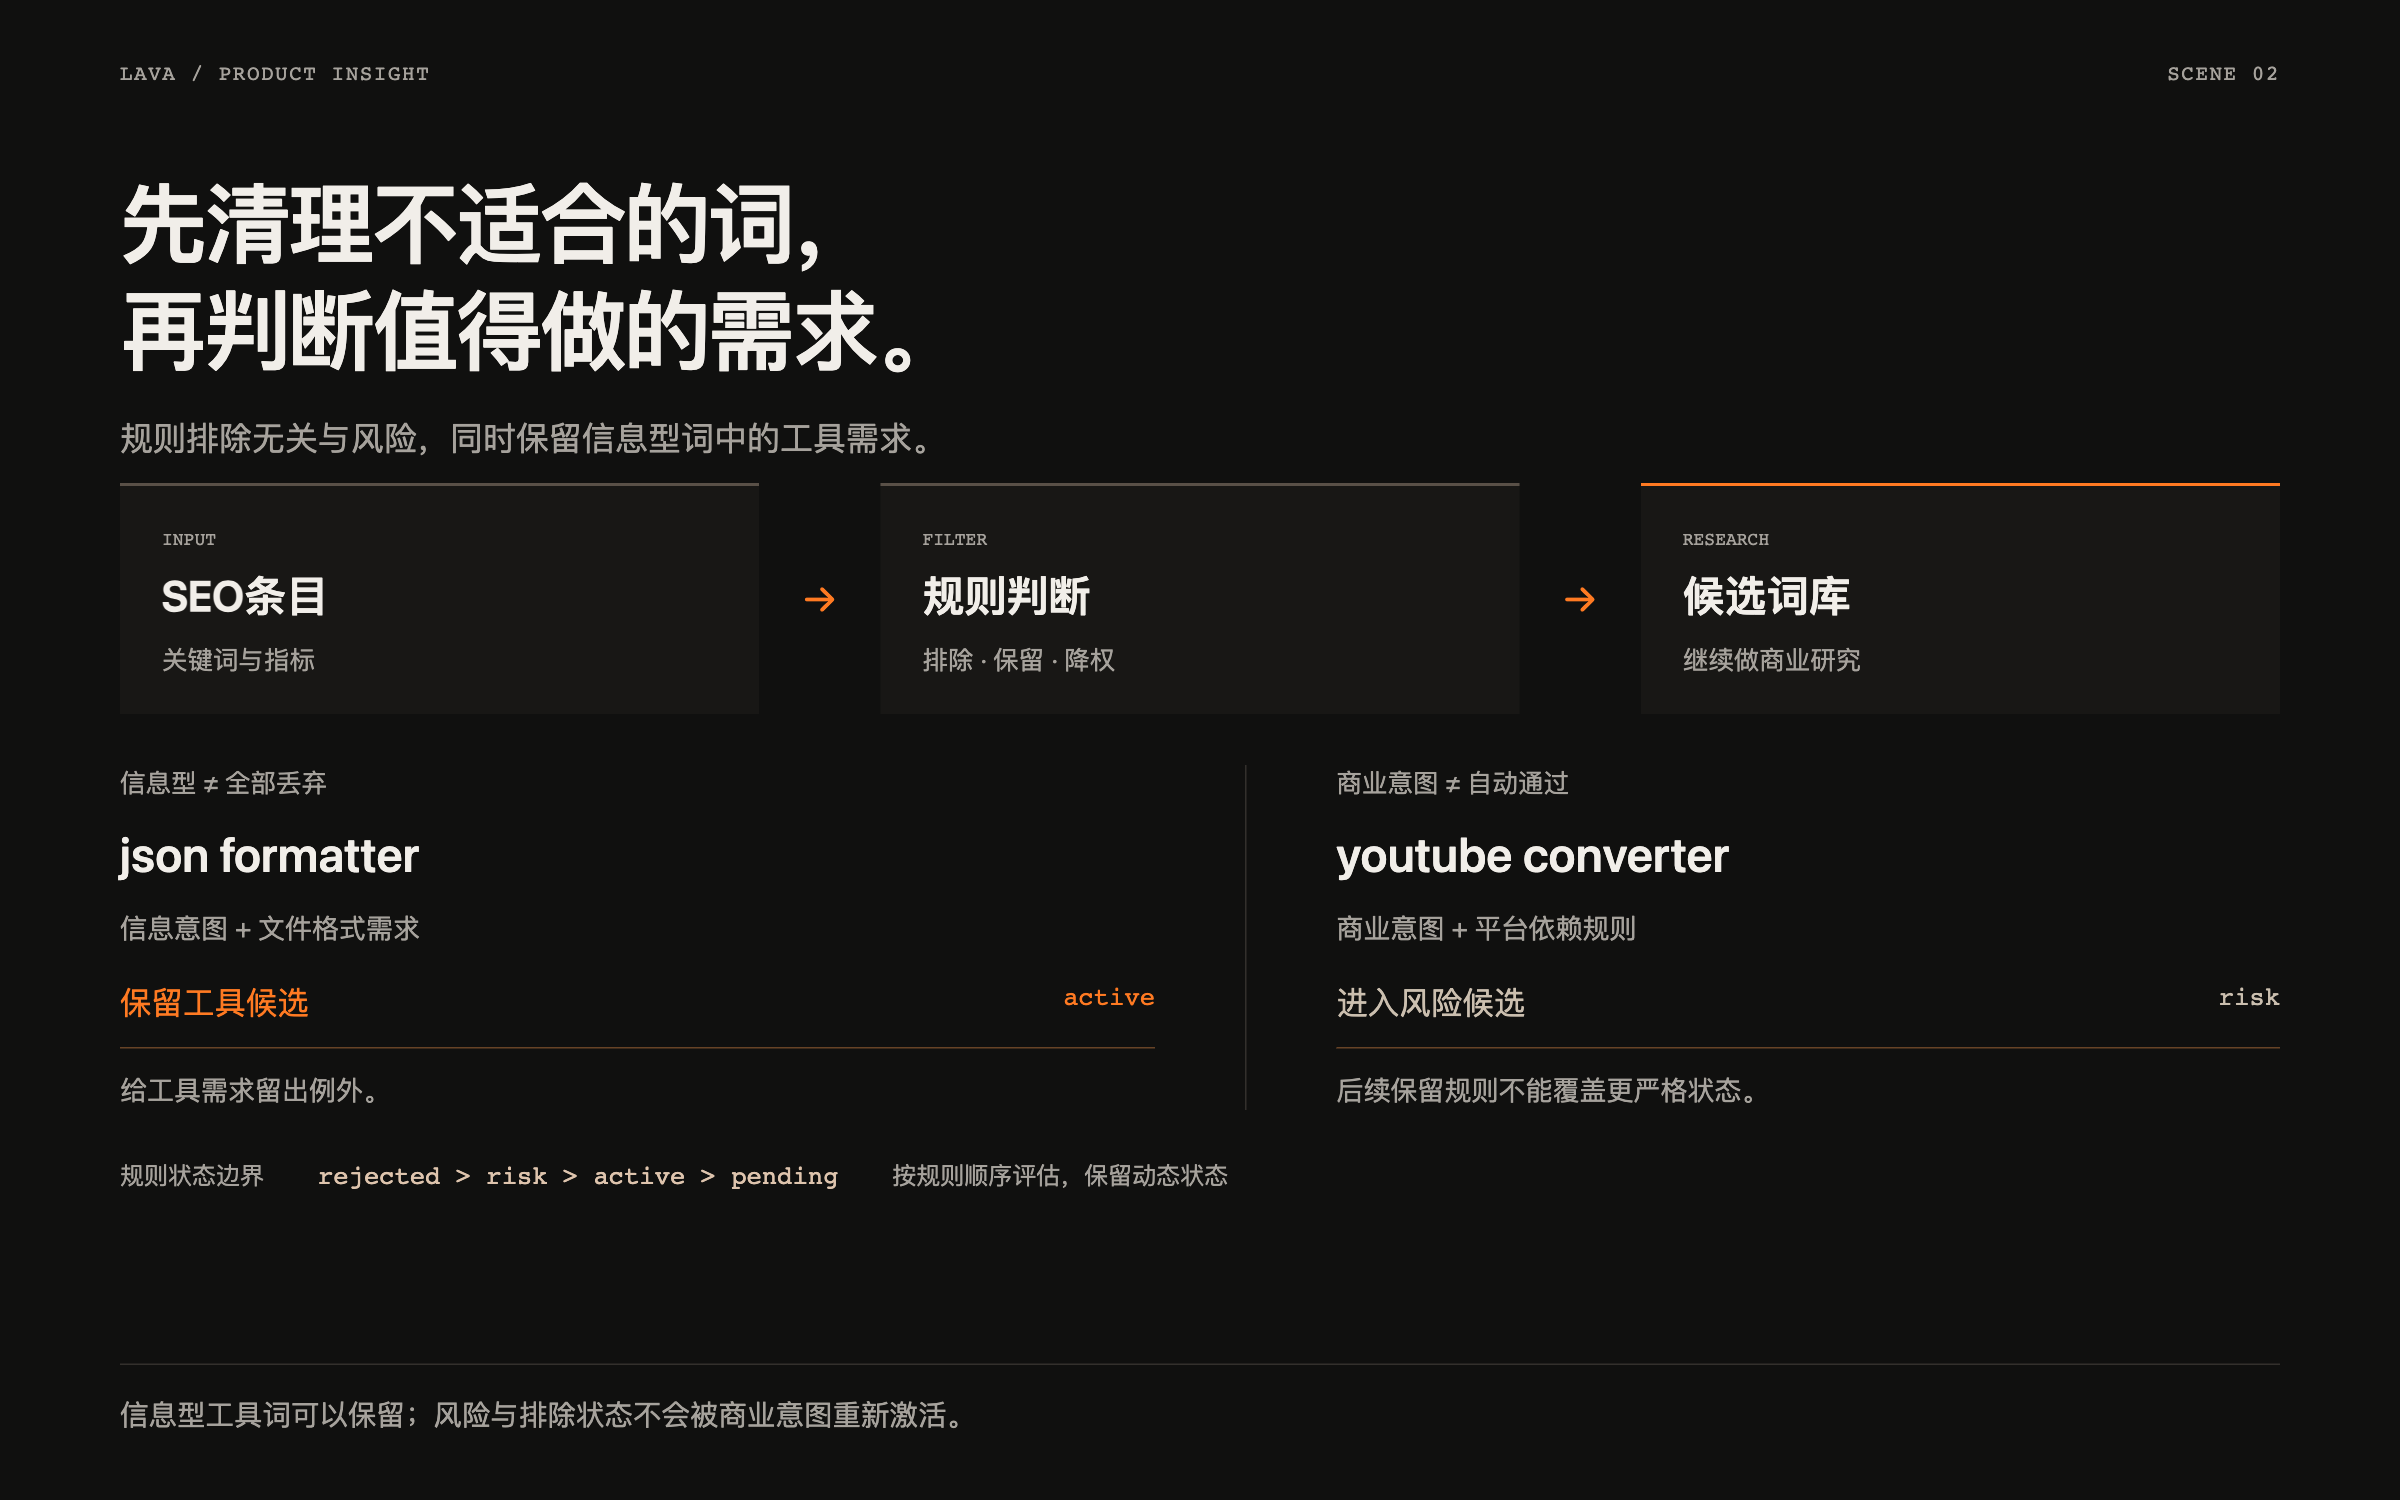
Lava 将重复判断整理成规则:保留搜索来源与指标,按条件排除无关或高风险条目,同时给工具型的信息关键词留出例外。风险与排除状态拥有更强优先级,避免它们被后续商业意图规则重新激活。
搜索量、CPC 与难度组成一个初筛排序值,帮助安排研究顺序。这个分数回答“先看哪些词”,不承担预测收入的任务。
保存每次研究的结果
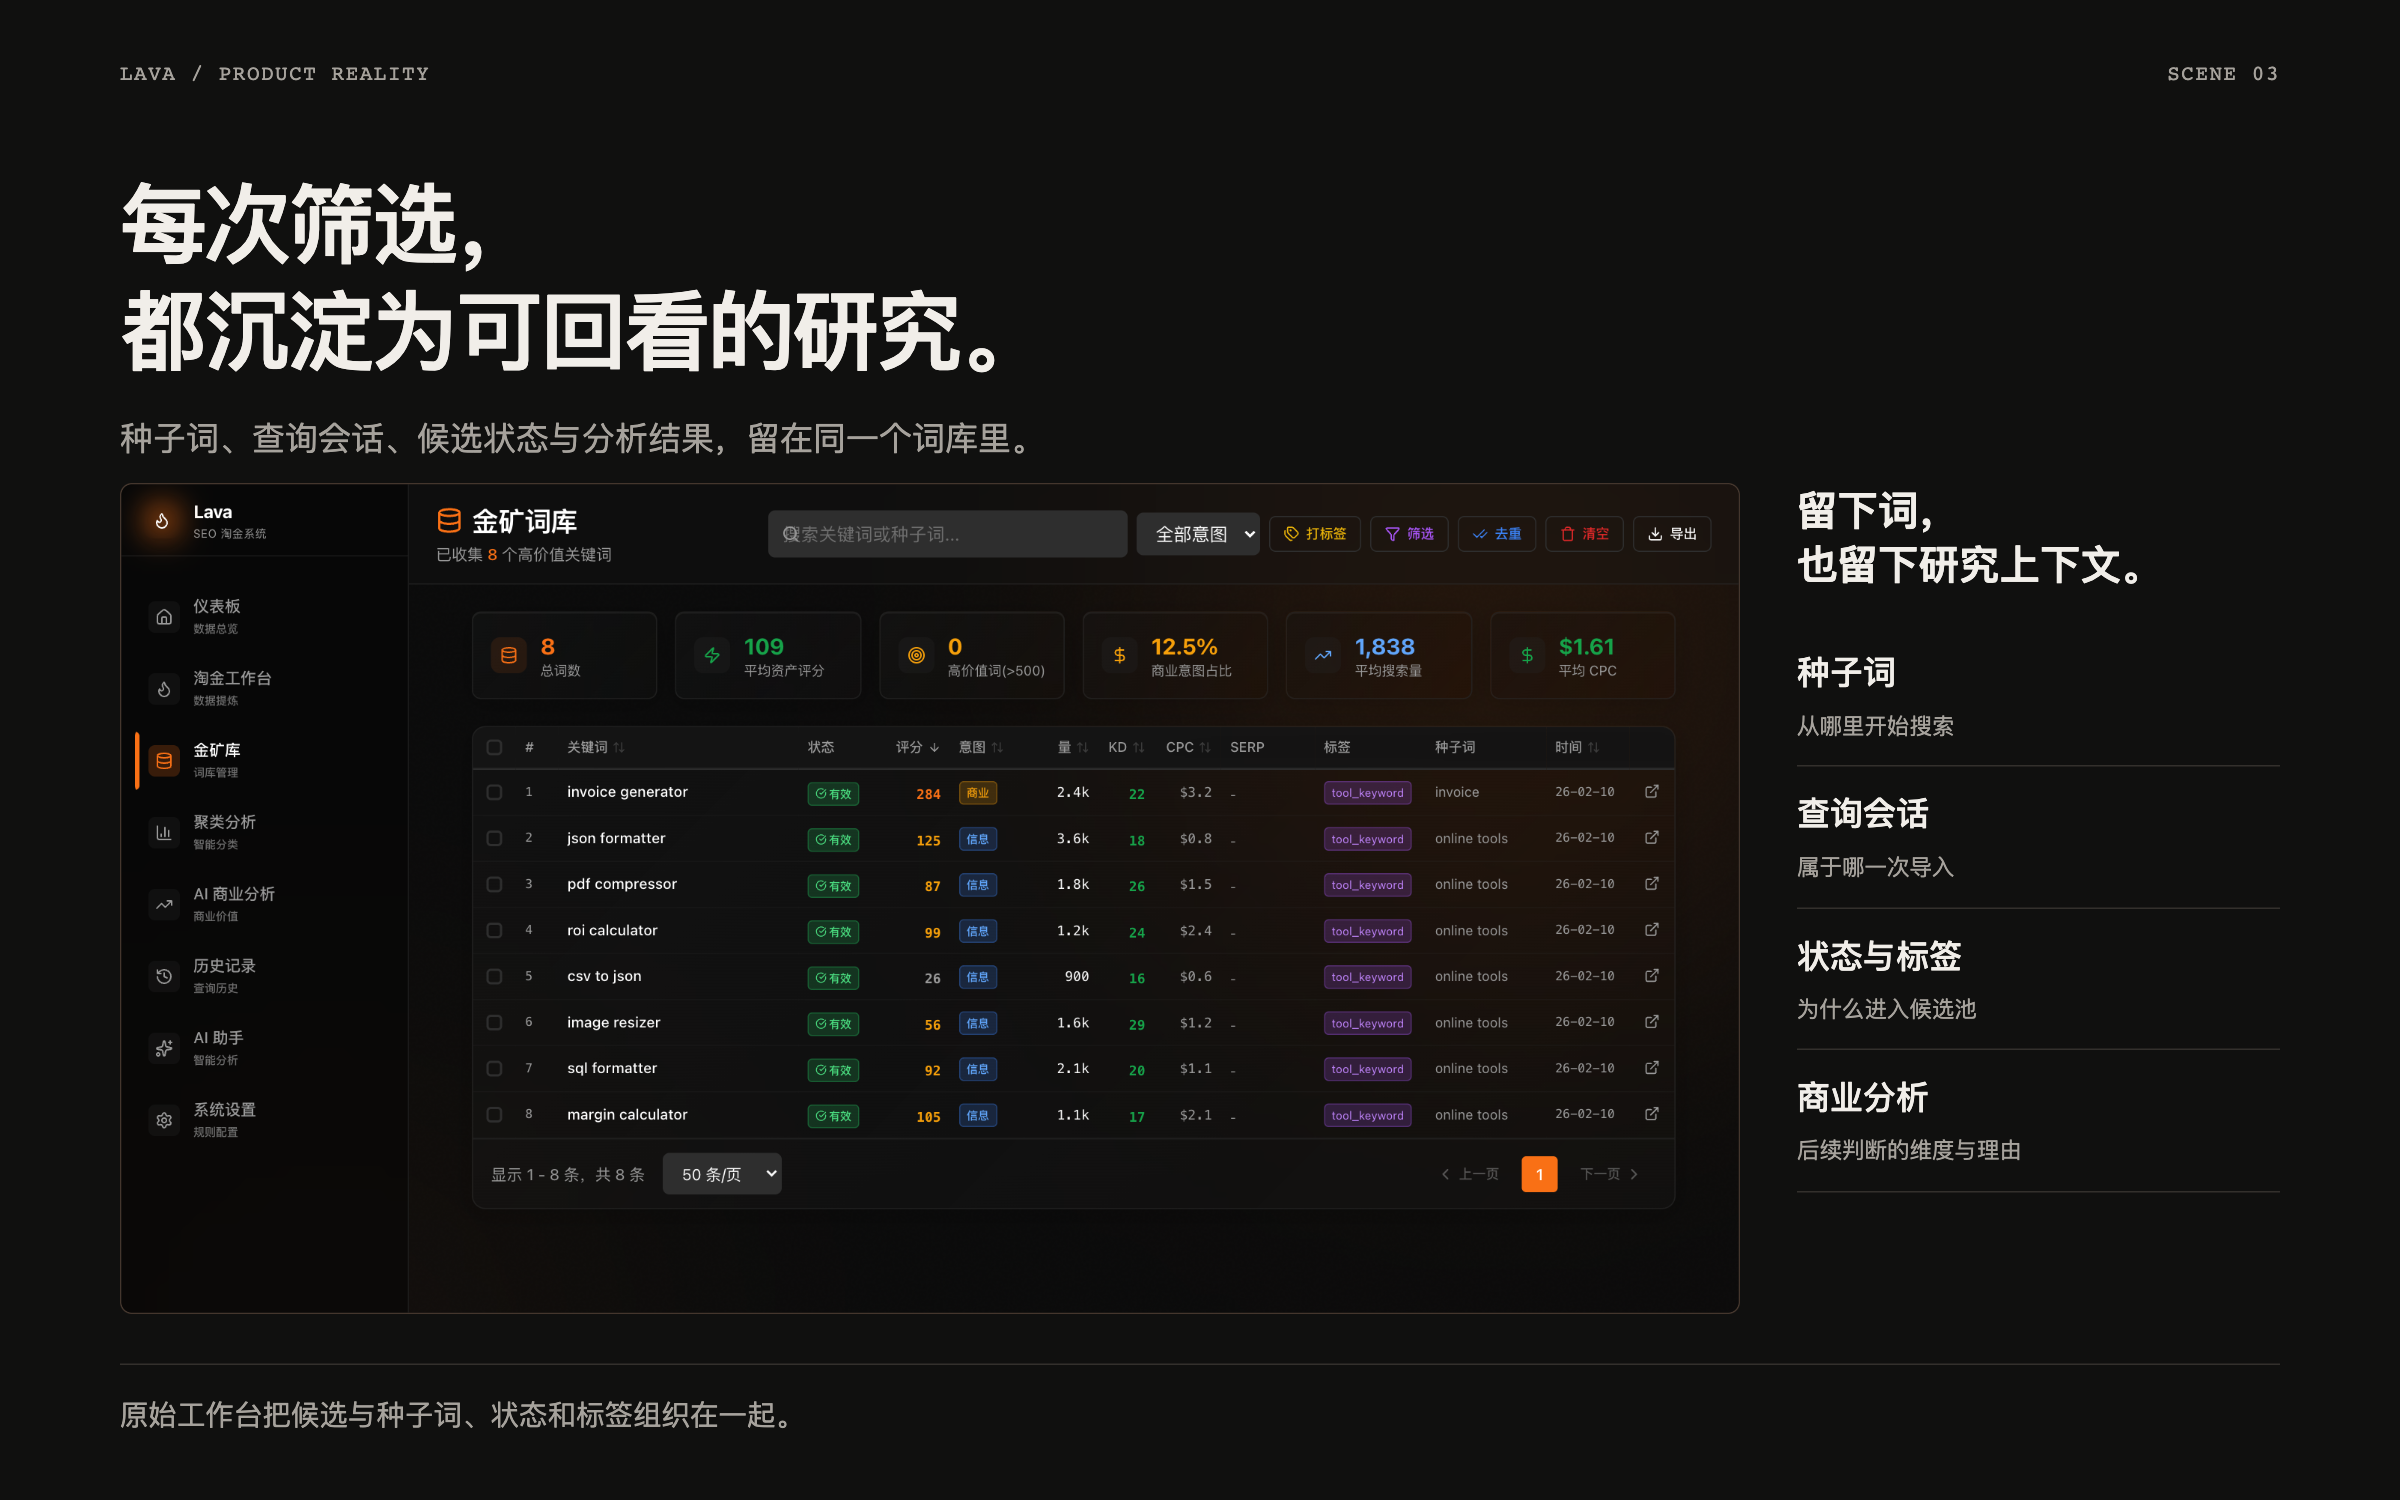
每次导入形成研究会话,保留种子词、文件与批次。筛选后的关键词进入同一词库,连同状态、标签与后续分析一起保存。
这让淘金成为一个持续积累的步骤:新的 SEO 数据可以继续进入,过去筛出的词可以再次比较,来源也有地方可回看。清洗、入库和继续分析因此属于同一个研究过程。
AI 分析的几个维度
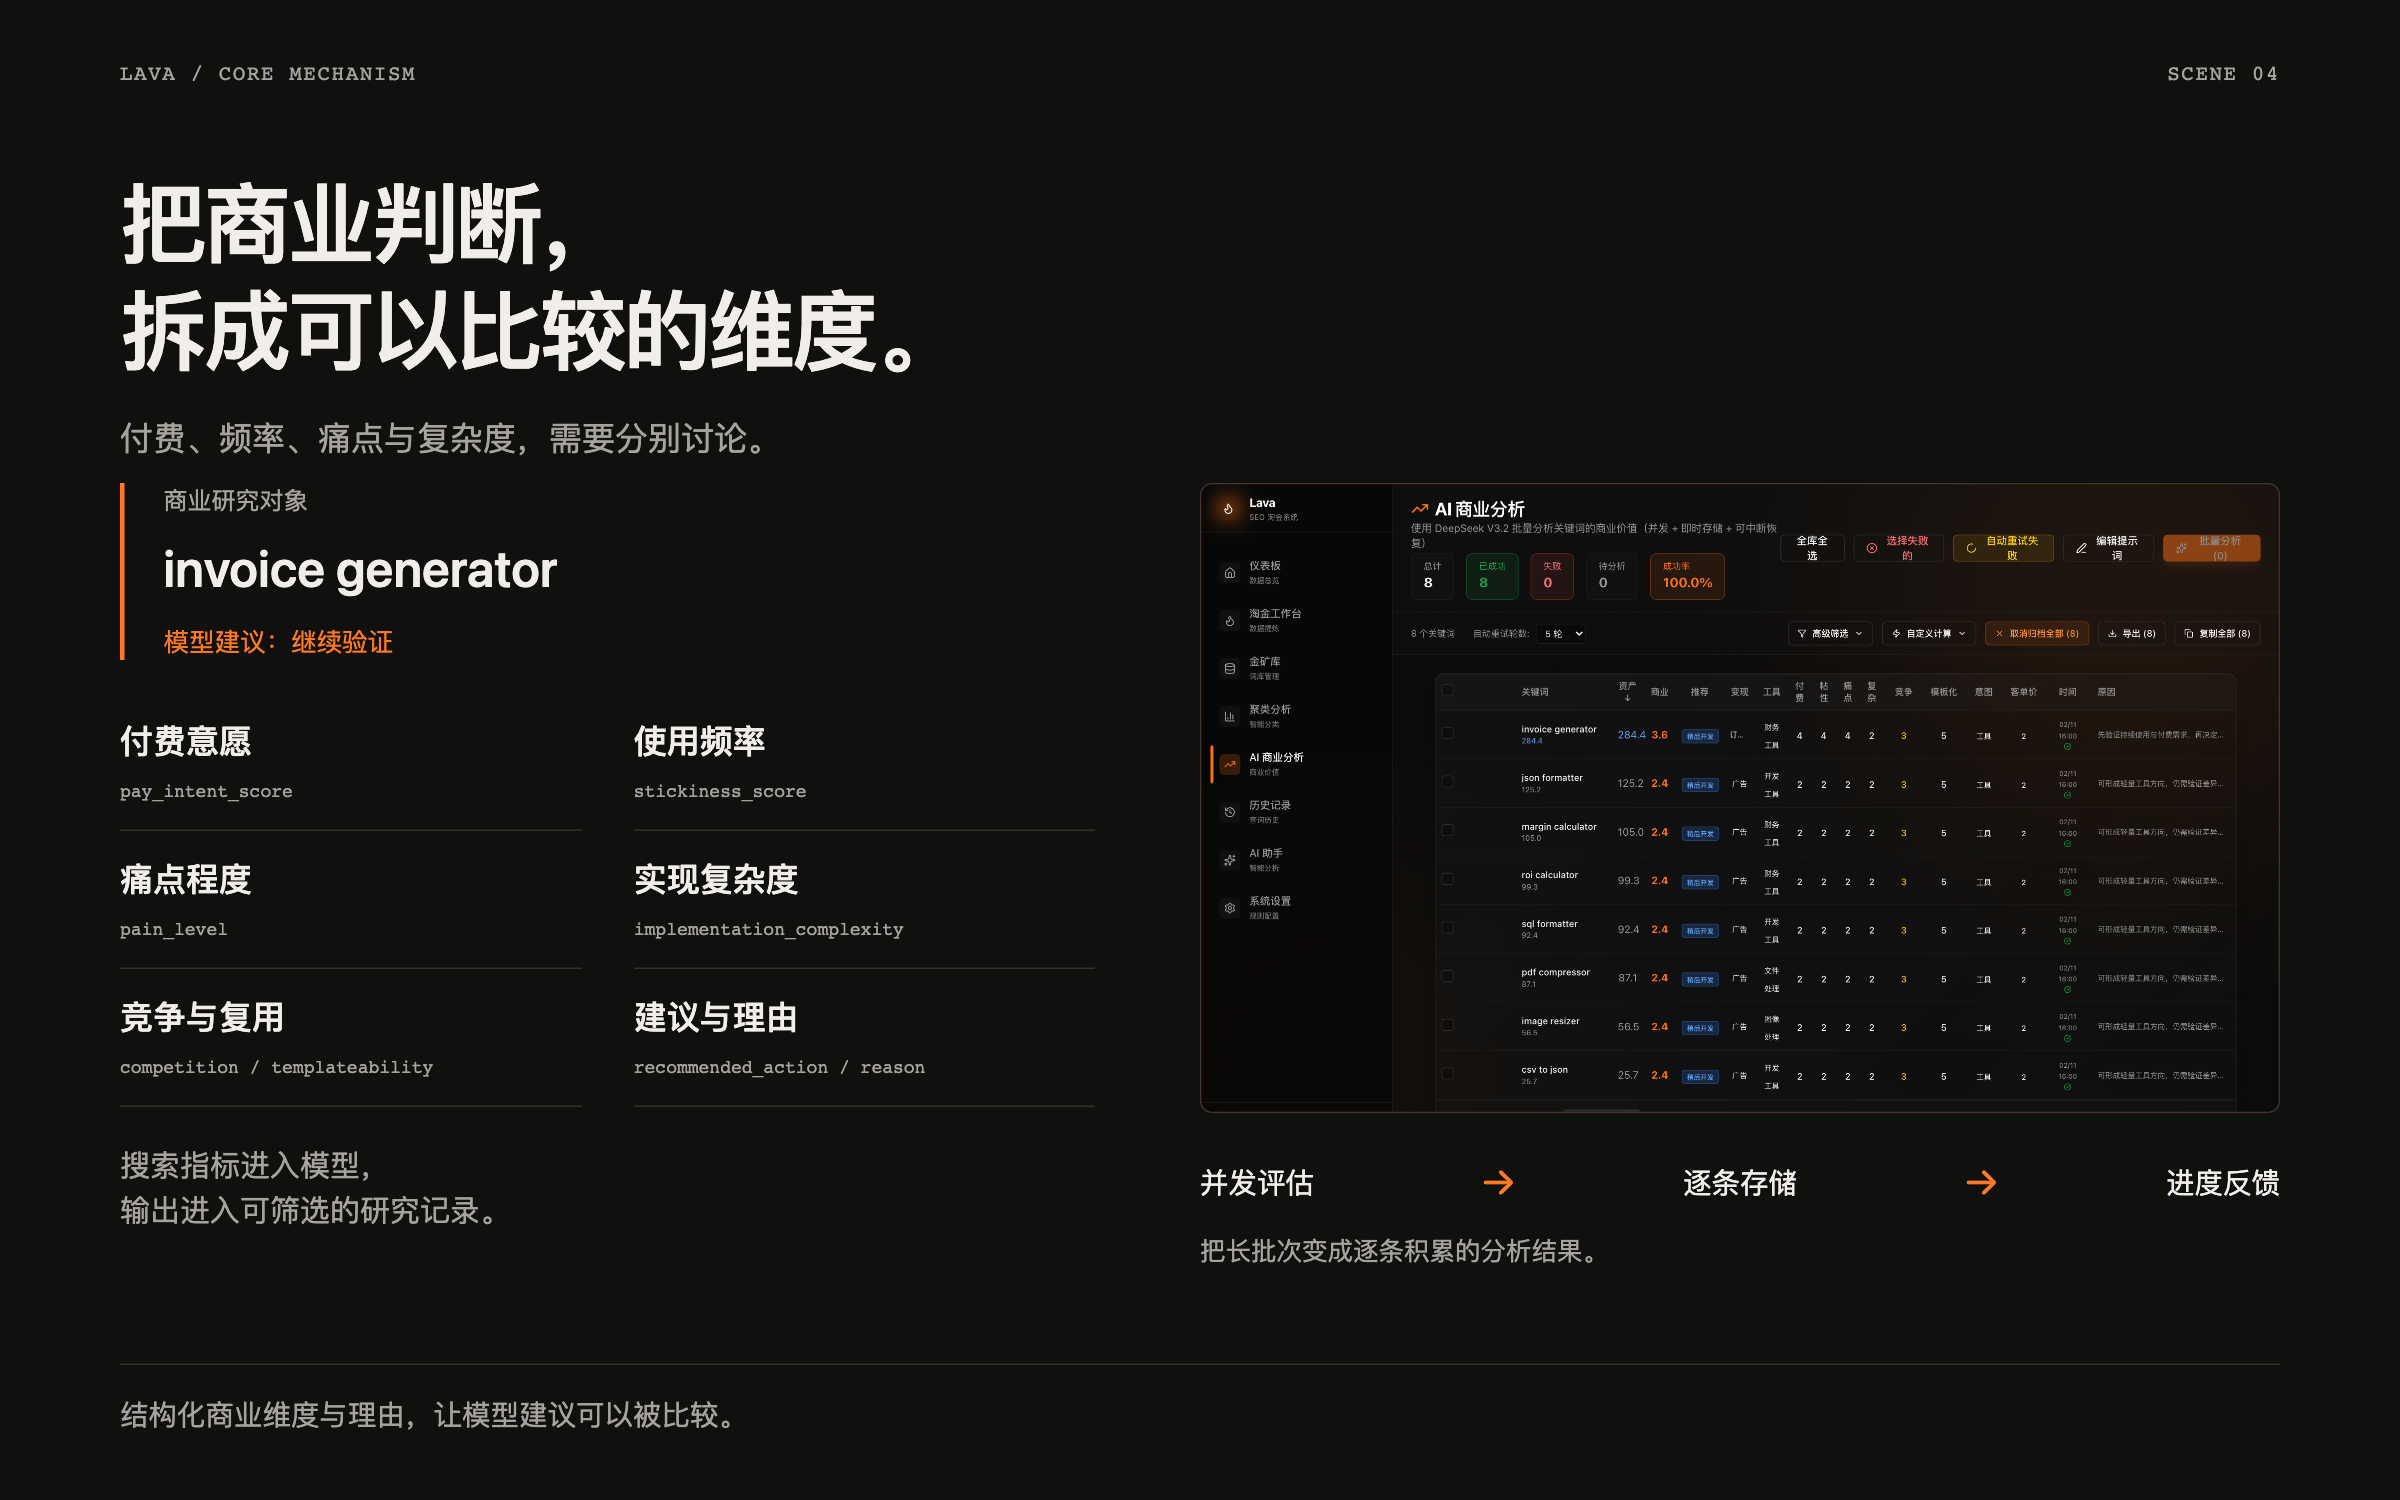
AI 商业分析围绕付费意愿、使用频率、痛点、实现复杂度、竞争与模板化程度展开。提示词将关键词及 SEO 指标作为输入,输出结构化维度、理由与建议动作。
相比再给一个总分,这种结构更方便追问:一个词被保留,是因为持续需求,还是容易构建?建议做订阅产品,还是轻量工具?界面允许按维度筛选和比较,模型判断也保留在关键词记录里。
批量分析逐条存储结果,并展示处理进度;一次研究无需等整批完成后才看到全部结果。分析维度提供研究假设,后续验证仍需要回到真实用户与使用场景。
哪些关键词适合一起做
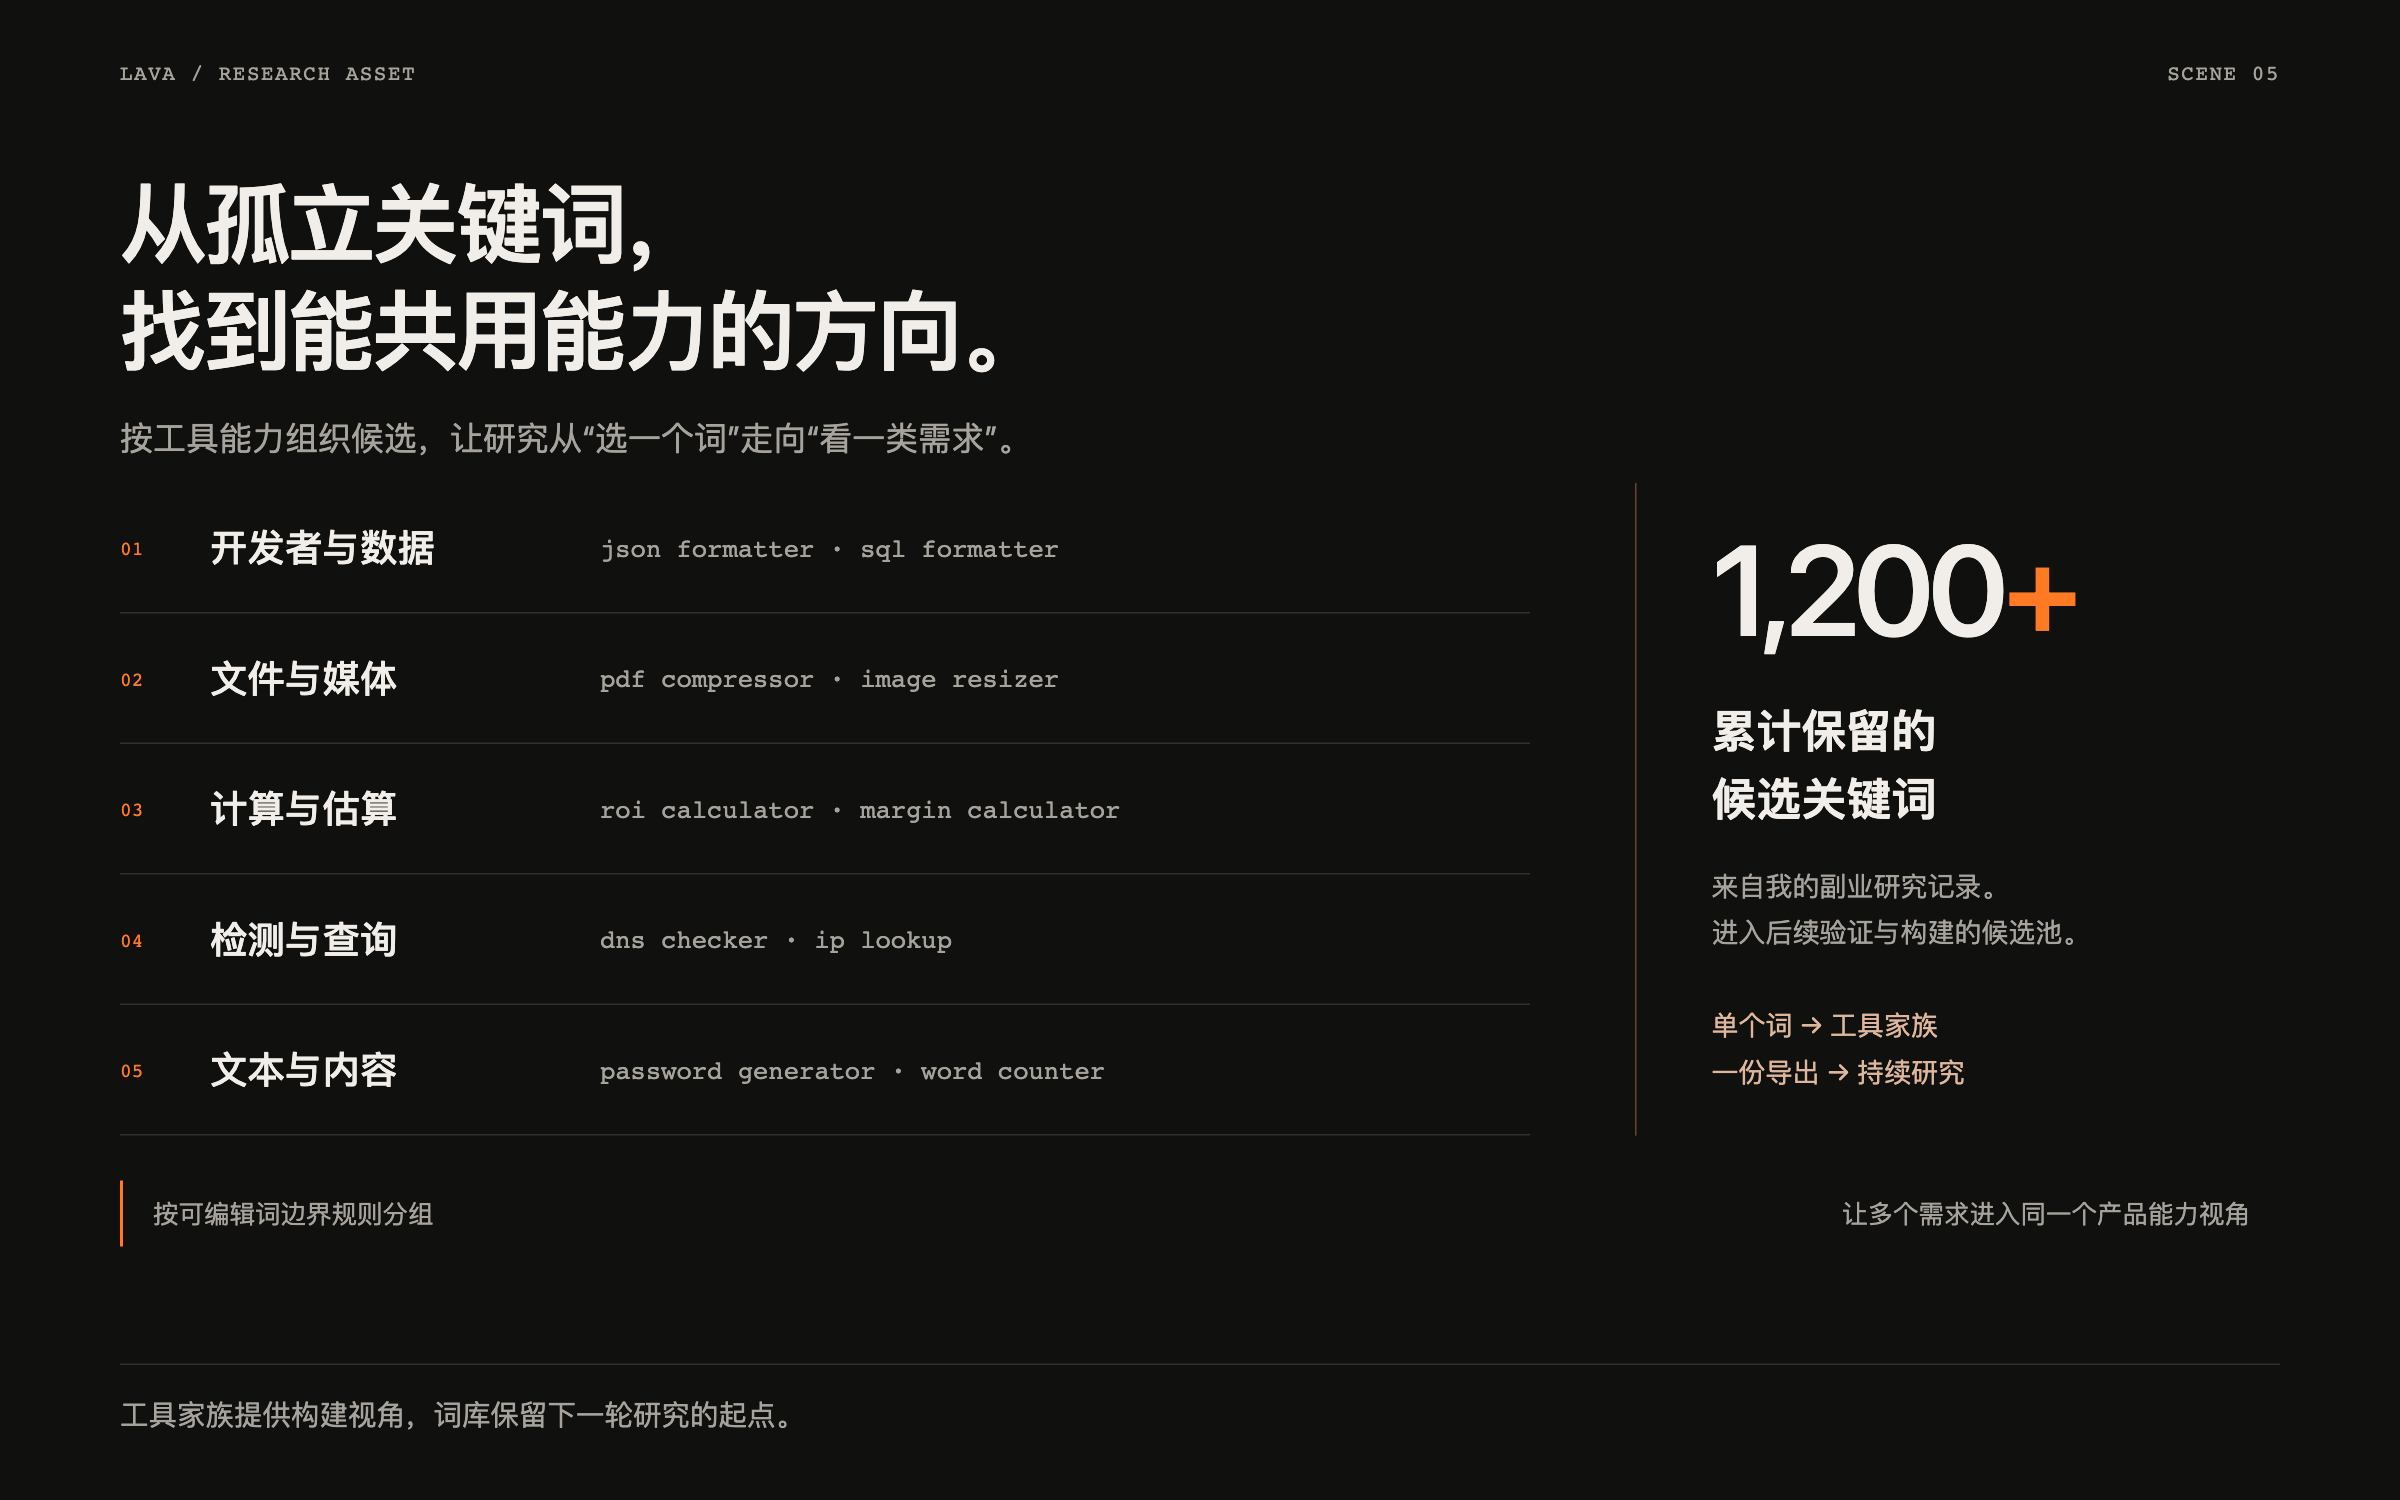
规则分组将候选词组织为开发者与数据、文件与媒体、计算与估算等工具家族。分组的意义不只是减少列表长度,而是换一个构建视角:哪些需求可能共享同一套产品能力?
例如,格式化和校验可以放在同一类数据工具中,压缩与转换可以作为文件工具方向继续研究。这里的分组根据词边界与可编辑规则产生,强调可理解的研究路径。
我做的部分
这个项目由我独立完成。我把自己的副业研究步骤落实成产品:组织导入与筛选路径、设计规则状态与例外、连接候选词库、构建商业维度分析,并让结果可以被比较、导出与回访。
在我的副业研究中,这套流程累计留下了 1,200 多条值得继续发展的候选关键词。它们构成研究资产,帮助我安排后续验证与构建的优先顺序。
Lava 将淘金从每次重新翻一份导出表,变成一个能继续积累的机会研究过程。
候选关键词和 AI 建议构成后续验证的起点。画面结合原始界面与流程重建,使用示例数据;展示的 SEO 指标与模型评估为示意。